Group Comparison
통계분석기법의 선택
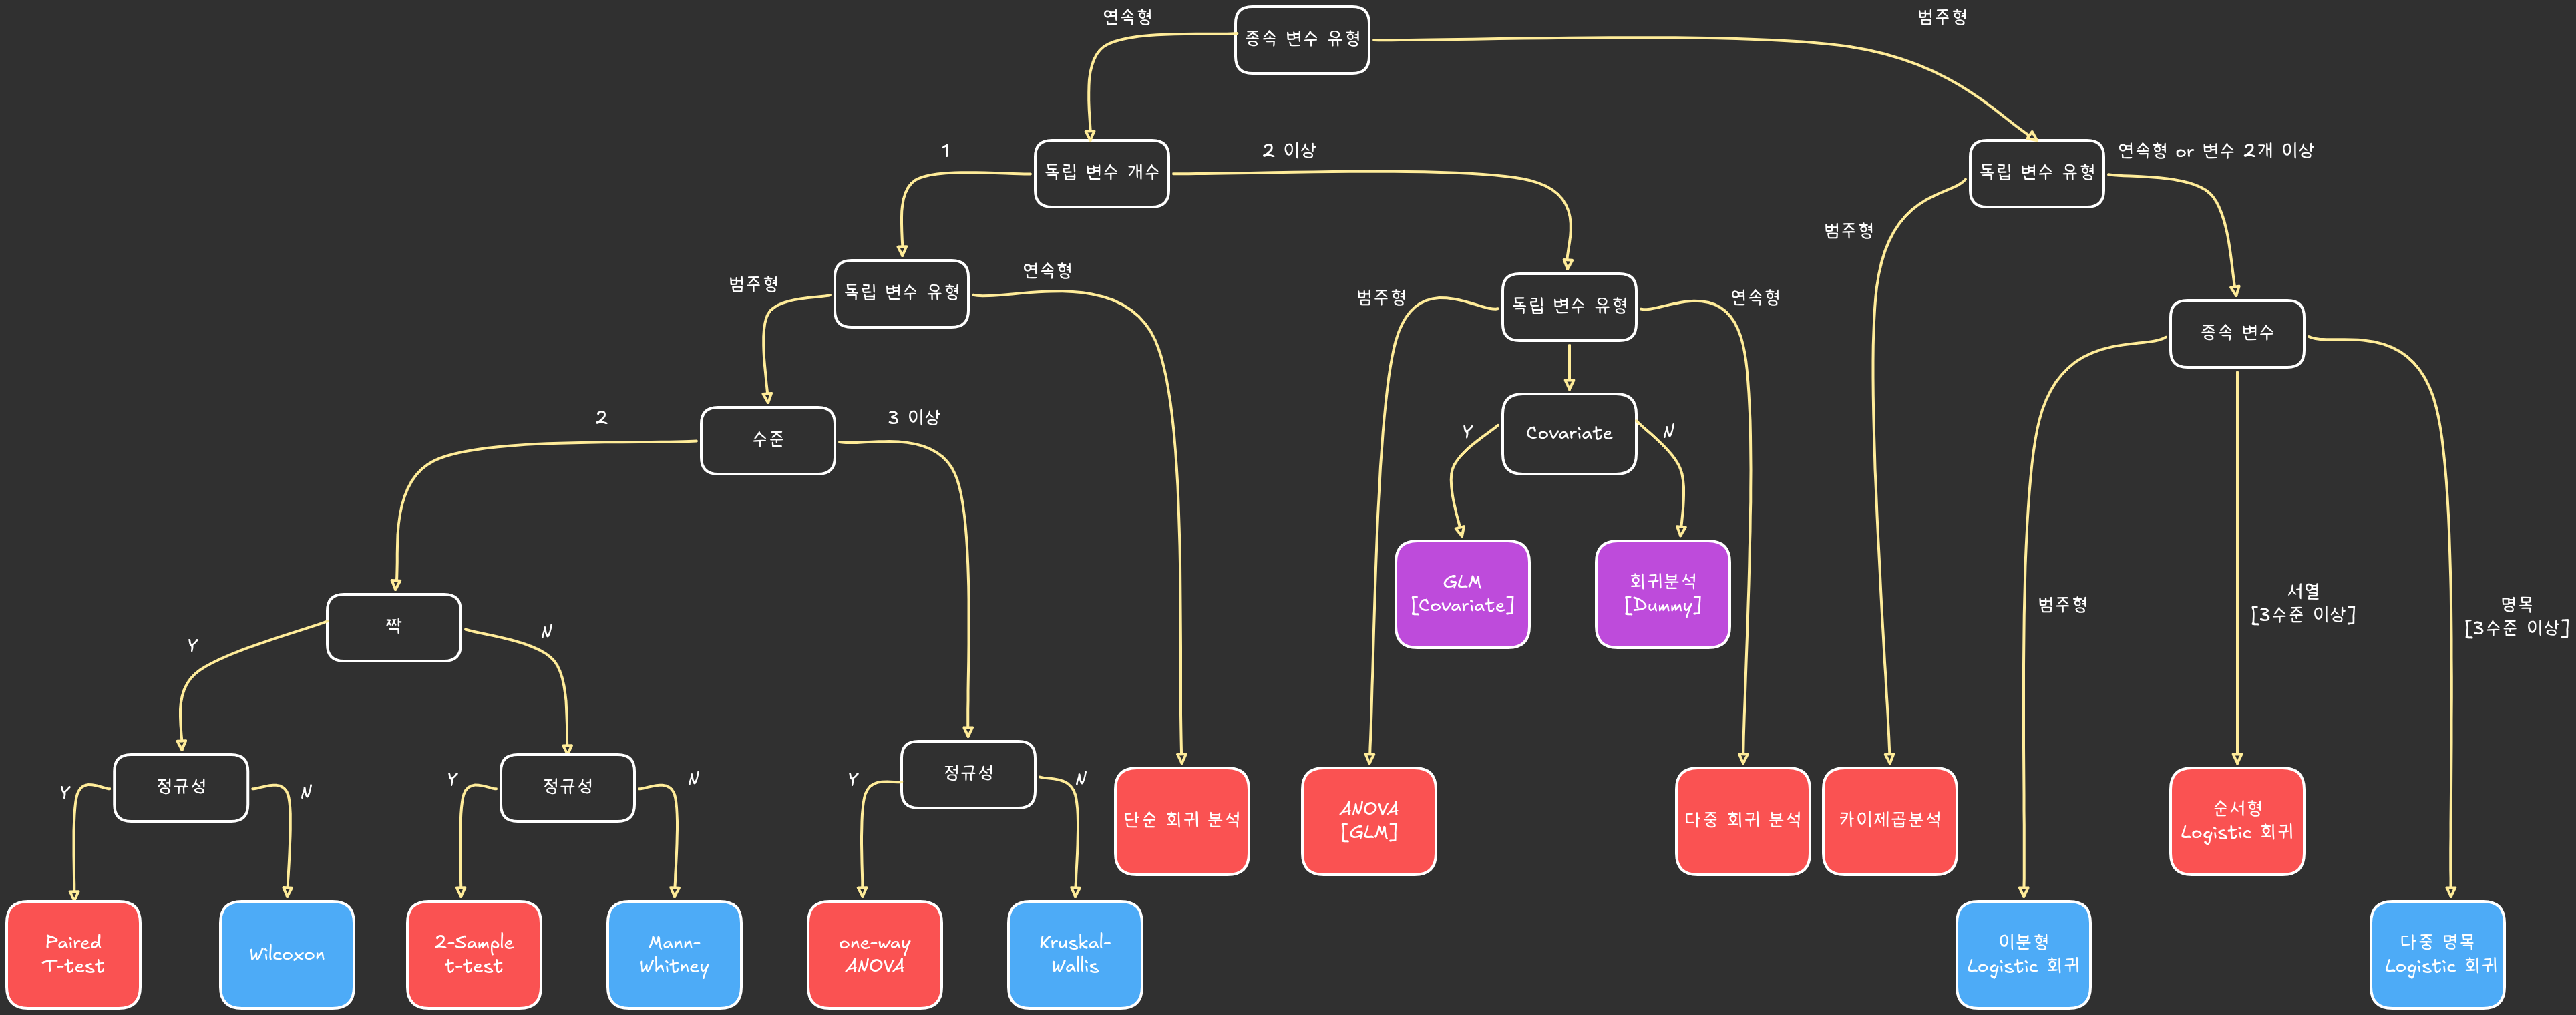
| 방법 | 대분류 | 설계/용도 | 종속변수 | 회귀·GLM로 표현 | 로버스트 SE 적용 |
|---|---|---|---|---|---|
| Paired t-test | 모수 검정 | 대응 2수준 평균차 | 연속 | 차이값의 1표본 t | 비해당(검정 자체) |
| Wilcoxon signed-rank | 비모수 검정 | 대응 위치차 | 순위 | 해당 없음 | 비해당 |
| 2-sample t-test | 모수 검정 | 독립 2집단 평균차 | 연속 | OLS(그룹 더미) | 가능 |
| Mann–Whitney | 비모수 검정 | 독립 2집단 위치차 | 순위 | 해당 없음 | 비해당 |
| One-way ANOVA | 선형모형(ANOVA) | 독립 k집단 평균차 | 연속 | OLS(범주 더미) | 가능 |
| Kruskal–Wallis | 비모수 검정 | 독립 k집단 위치차 | 순위 | 해당 없음 | 비해당 |
| 단순회귀분석 | 선형모형(OLS) | X 1개 | 연속 | OLS | 가능 |
| ANOVA (GLM) | 선형모형 | 범주 예측자 | 연속 | GLM(가우시안) | 가능 |
| GLM (covariate, ANCOVA) | 선형모형 | 범주+공변량 | 연속 | OLS/가우시안 GLM | 가능 |
| 회귀분석 (Dummy) | 선형모형 | 범주 더미화 | 연속 | OLS | 가능 |
| 다중 회귀 분석 | 선형모형(OLS) | X 다수 | 연속 | OLS | 가능 |
| 카이제곱 분석 | 범주형 검정 | 독립성/적합도 | 명목 | 로그선형(포아송)으로 대체 가능 | 기본 검정은 비해당 · 로그선형은 가능 |
| 이분형 Logistic 회귀 | GLM | 회귀 | 이분 | GLM(logit) | 가능 |
| 순서형 Logistic 회귀 | GLM 확장 | 회귀 | 순서형 | 누적 logit | 가능 |
| 다중 명목 Logistic 회귀 | GLM 확장 | 회귀 | 명목 다범주 | 다항 logit | 가능 |
개념
정규성
정규 분포를 따른다. 정규 분포도를 평가하는 도구 - t-test - Mann-Whitney U test - ANOVA
등분산성
- 등분산성 확인 불가 -> welch ANOVA , welch t test 테스트
모분산이 알려져 있는 경우 (Two-Sample Z-test)
두 집단의 데이터가 서로 독립적인 정규분포에서 나온 것이라고 하고, 다음과 같은 가정을 하자 \(x_1,x_2,\cdots,x_{n1}\) 은 평균 \(\mu_1\) , 분산 \(\sigma_1^2\) 인 정규분포를 따르는 모집단에서 나온 표본이다. \(y_1,y_2,\cdots,y_{n2}\) 는 평균 \(\mu_2\) , 분산 \(\sigma_2^2\) 인 정규분포를 따르는 모단에서 나온 표본이다. 두 표본은 서로 독립이다.
모 평균의 차이 : \(\mu_1 - \mu_2\) 모 평균의 차이의 추정량 : \(\bar x - \bar y\) 이를 표준화한 Z 는 다음과 같다.
Z 는 표준정규분포를 따른다는 사실을 이용하여 가설 검정을 할 수 있다. 일반적으로 두 모평균의 차이 \(\delta\) 를 검정하기 위한 검정 통계량은
\(H_0\) : \(\mu_1 - \mu_2 = \delta\) , \(H_1\) : \(\mu_1 - \mu_2 > \delta\) 일때, \(Z > z_\alpha\) 이면 귀무가설 기각 \(H_0\) : \(\mu_1 - \mu_2 = \delta\) , \(H_1\) : \(\mu_1 - \mu_2 < \delta\) 일때, \(Z < - z_\alpha\) 이면 귀무가설 기각 \(H_0\) : \(\mu_1 - \mu_2 = \delta\) , \(H_1\) : \(\mu_1 - \mu_2 \neq \delta\) 일때, \(\lvert Z \rvert \neq z_{\alpha/2}\) 이면 귀무가설 기각
여기서 \(\delta=0\) 으로 놓으면, 두 모평균의 동일성 \(\mu_1=\mu_2\) 에 관한 검정이 될 것이다. 이 때, \(Z_\alpha\) 는 표준 정규분포에서 상위 \(\alpha\) 의 확률 을 갖는 임계치를 의미한다. 모평균의 차이의 100(1-\(\alpha\))% 신뢰구간은 다음과 같다.
모분산이 알려져 있지 않은 경우 (Two-sample t-test)
두 집단의 표본의 크기가 모두 큰 경우 (n \(\geq\) 30)는 모분산을 알고 있지 않더라도, 또한 모집단이 정규분포를 따르지 않더라도 정규분포를 이용한 검정이 가능하다. 이 때에는 모분산의 추정치로 표본 분산을 사용하게 된다.
여기서, \(s_1\) 과 \(s_2\) 는 각각 두 집단에서의 표본표준편차이다. ( 따라서 \(s_1^2\) 과 \(s_2^2\) 은 각 집단의 표본 분산이다.)
두 집단의 평균 비교
데이터의 크기가 충분히 큰가?
| 구분 | 데이터 크기 충분 | 정규성 |
|---|---|---|
| Two Sample t-test | True | True |
| Mann-Whitney U test | True | False |
| 구분 |
Two-sample t-test | Mann-Whitney U test |
|---|---|---|
| 독립성 | 두 표본 독립 | 두 표본 독립 |
| 정규성 | 각 집단이 정규성을 가진다 (n 이 충분히 크면 완화, 중심 극한 정리) |
정규성 가정 불필요 |
| 분산 | Equal Variance t test : 등분산 Welch t test : 이분산 |
분포의 모양이 유사할 경우만 중앙값 비교로 해석 가능 |
| 검정 대상 | 두 집단의 평균 차이 | 두 집단의 순위/중앙값 차이 |
| 장점 | 평균 차이를 직접적으로 해석 가능 정규분포 하에서 Powerful 표본수가 크면 정규성 위배에도 강건 |
정규성 가정 불필요 이상치와 비 정규 분포에 강건 |
| 한계 | 소표본일때 정규성 위반시 부적절 이상치에 민감 |
분포 모양이 다르면 중앙값 비교 불가 효과 크기 해석이 직관적이지 않음 소표본일때 검정력(Power) 낮음 |
Two sample t test
정의
두 표본이 독립된 모집단으로 부터 추출된 것일때 두 모집단의 평균을 비교하는 검정방법
모형과 가설
- 모분산을 아는 경우
- 모분산이 다른 경우
- 두 모집단의 모분산이 동일한지 F 검정을 통해 테스트 \((\sigma_1^2 = \sigma_2^2)\) , (\(\sigma_1^2 \neq \sigma_2^2\))
- \(\delta\) 의 신뢰구간
- 검정통계량
- 검정통계량의 분포
- 유의 확률
모분산이 같은 경우
먼저 두 모집단이 동일한 분산을 갖는다고 가정할 수 있는지 살펴본다.
예제 1
한 연구자는 건강한 사람 5명, 부갑상선 기능 항진증 환자 12명에 대하여
혈청 중의 칼슘량을 측정하여 건강한 사람의 혈중 칼슘량이 더 많은 지를 조사하였다.
실험 결과 건강한 사람의 평균 칼슘량이 12.9 이고,
기능 항진증 환자들의 혈청중의 평균 칼슘량은 9.9 로 측정되었다.
두 그룹의 자료는 정규 모집단에서 독립적으로 뽑힌 확률표본이라고 가정하고
모분산은 각각 0.69와 0.175로 알려져 있다고 할때,
두 그룹의 혈중 칼슘량 평균이 같다고 할 수 있을까?
예제 2 - 모분산이 같은 경우
다음 자료는 뚜렷한 폐기종 발전 이전의 흡연자에 대해 폐 파괴 현상을 조사한 것이다.
비흡연자 집단과 호흡기질환 외의 다른 원인으로 사망한 흡연자 집단에 대해
폐파괴지수를 측정하였다. (높은 수치는 폐의 손상됨이 크다는 것을 뜻한다).
각 그룹의 관측치들은 독립적으 로 얻어진 것이며,
두 그룹에서의 모분산은 같다고 가정한다.
흡연자와 비흡연자의 폐 파괴 지수의 평균이 같다고 할 수 있는가?
smoke = {16.6, 13.9, 11.3, 26.5, 17.4, 15.3, 15.8, 12.3, 18.6, 12.0, 24.1, 16.5, 21.8, 16.3, 23.4, 18.8}

non_smoke = {18.1, 6.0, 10.8, 11.0, 7.7, 17.9, 8.5, 13.0, 18.9}
예제 2 - 모분산이 다른 경우
다음 자료는 뚜렷한 폐기종 발전 이전의 흡연자에 대해 폐 파괴 현상을 조사한 것이다.
비흡연자 집단과 호흡기질환 외의 다른 원인으로 사망한 흡연자 집단에 대해 폐파괴지수를 측정하였다. (높은 수치는 폐의 손상됨이 크다는 것을 뜻한다).
각 그룹의 관측치들은 독립적으 로 얻어진 것이며,
두 그룹에서의 모분산은 다르다고 가정한다.
흡연자와 비흡연자의 폐 파괴 지수의 평균이 같다고 할 수 있는가?
smoke = {16.6, 13.9, 11.3, 26.5, 17.4, 15.3, 15.8, 12.3, 18.6, 12.0, 24.1, 16.5, 21.8, 16.3, 23.4, 18.8}

non_smoke = {18.1, 6.0, 10.8, 11.0, 7.7, 17.9, 8.5, 13.0, 18.9}
Mann-Whitney U test in SAS
GroupA = {70, 60, 45, 90, 95, 80, 85}
GroupB = {100, 95, 55, 65, 75, 75}
- 그룹 A,B 통합 후 내림차순 정렬
- 등수 부여 ( 같은 값을 가지는 원소는 묶어 평균을 낸 등수를 부여한다)
- 그룹별 등수의 합 계산 :
- 그룹별 U-statics 계산
-> A 그룹에서 두개를 뽑는 경우의 수
-> B 그룹에서 두개를 뽑는 경우의 수
\(\therefore\) 같은 그룹에서 뽑는 경우를 제외한다. - 정규 근사를 통한 차이 검정
짝지은 표본의 비교
| 구분 | Paired t-test | Wilcoxon's signed rank test |
|---|---|---|
| 독립성 | 각 쌍은 서로 독립적 | 각 쌍은 서로 독립적 |
| 정규성 | 차이값이 정규 분포를 따라야함 | 정규성 가정 불필요 (차이값 분포가 대칭적이어야 함) |
| 검정대상 | 두 시점(조건)의 평균 차 | 두 시점(조건)의 중앙값 차 |
| 장점 | 정규성 만족시 검정력 높음 계산 및 해석이 단순함 |
정규성 가정 불필요 이상치에 강건 |
| 한계 | 소표본일때 정규성 위반시 부적절 이상치에 민감 |
정규성 만족시 paried t-test보다 검정력(Power) 낮음 |
Paired t-test
예제 1
| ID | Before | After | Difference |
|---|---|---|---|
| 1 | \(x_1\) | \(y_1\) | \(d_1\) |
| 2 | \(x_2\) | \(y_2\) | \(d_2\) |
| ... | ... | ... | ... |
| n | \(x_n\) | \(y_n\) | \(d_n\) |
가정 : 관측치 간 차 ( \(d_1\;,\;d_2\;,\;\cdots\;,\;d_n\)) 이 서로 독립이고 같은 정규분포를 따른다. -> i.i.d : Independent, Identically Distribution 가설 :
검정 통계량 :
Wilcoxon's signed rank test
예제 1
| Before | After | diff |
|---|---|---|
| 28 | 29 | 1 |
| 26 | 22 | -4 |
| 37 | 31 | -6 |
| 32 | 33 | 1 |
| 25 | 19 | 6 |
| 20 | 27 | 7 |
| 33 | 18 | -17 |
Process
- 절대값 기준 정렬
- 등수 부여 ( 같은 값을 가지는 원소는 묶어 평균을 낸 등수를 부여한다)
- signed ( 부호 부여 )
- 양의 순위합 및 음의 순위합 산출
계산
- 검정통계량
- 정규 근사를 통한 p-value 계산
여러 집단의 평균 비교
- 두 집단 ( 실험군 vs 대조군 ) 의 평균 비교 방법
증명
| 구분 | 정규성 | 등분산성 |
|---|---|---|
| Kruskal-Wallis | X | - |
| ANOVA | O | O |
| Welch ANOVA | O | X |
| 구분 | ANOVA | Welch ANOVA | Kruskal-Wallis Test |
|---|---|---|---|
| 가정 | 집단별 정규성 등분산성 독립성 |
집단별 정규성 독립성 |
분포모양 동일 독립성 |
| 검정통계량 | F | Welch F | 순위합기반 통계량 |
| 장점 | 정규성, 등분산 만족시 강력 | 등분산 가정 불필요 실제 자료 적용성 증가 |
정규성/등분산 가정 불필요 |
| 한계 | 등분산성 위배 시 민감 | 표본 크기차이가 크면 결과에 영향을 미친다. | 검정력이 낮음 |
일원분산분석법
- 집단 평균을 비교하고자 할때, 집단이 3개 이상인 경우 사용한다.
- 요인 (Factor) : 집단을 나누는 범주
- 모형 :
- 요인의 수준이 k 개 일때, 각 집단에서 표본 추출
- 가정
- 모집단 정규성 : 각 집단이 정규 분포를 따른다.
- 등분산성 : 모든 집단의 분산이 동일하다.
- 독립성 : 각 관측치는 서로 독립이다.
| 구분 | \(G_1\) | \(G_2\) | \(\cdots\) | \(G_k\) |
|---|---|---|---|---|
| 데이터 | \(y_{11},y_{12},\cdots,y_{1n_1}\) | \(y_{21},y_{22},\cdots,y_{2n_1}\) | \(y_{k1},y_{k2},\cdots,y_{kn_k}\) | |
| 크기 | \(n_1\) | \(n_2\) | \(n_k\) | |
| 평균 | \(\bar y_1\) | \(\bar y_2\) | \(\bar y_k\) | |
| 표준편차 | \(S_1\) | \(S_2\) | \(S_k\) |
- \(n\;=\;n_1\;+\;n+2\;+\;n_k\)
- \(\bar y\;=\;(y_{11}\;+\;\cdots\;+\;y_{kn_k})\;/\;n\)
Total Sum of Squares = Treatment Sum of Squares + Error Sum of Squares
SST = SSt + SSE
T -> Total t -> treatment sum of squares
안 sigma -> j 의 합 : 샘플수 밖 sigma -> i 의 합 : 집단 처리에서의 자유도 : 그룹의 개수 -1 오차에서의 자유도 : 전체 데이터 셋 - 그룹의 개수 계 : \(\nu\;=\;n-1\)
증명
요소
- \(y_{ij}\) : 각 요소의 값
- \(\bar y_i\) : 특정 그룹의 평균 값
- \(\bar y\) : 모든 그룹의 평균 값
- \(y_{ij}\;-\;\bar y\) : 모든 그룹의 평균값 - 각 요소의 값
- \(y_{ij}\;-\;\bar y_i\) : 특정 그룹의 평균 값 - 각 요소의 값
- \(\bar y_i\;-\;\bar y\) : 모든 그룹의 평균 값 - 특정 그룹의 평균 값
전개
$$
\begin{align} &y_{ij}\;-\;\bar y\;=\;y_{ij}\;-\;\bar y_i\;+\;\bar y_i\;-\;\bar y \;=\; \ &y_{ij}\;-\;\bar y \end{align} $$
- 제곱
- 합
-> \(\sum_i\sum_j\;(\bar y_i\;-\;\bar y)^2\;=\;\sum_i n_i\;(\bar y_i\;-\;\bar y)^2\)
- 교차항 제거
-> 교차항은 0 이 된다.
결론
- 검정 통계량
- MSt : 집단간 평균 차이 (집단 평균과 전체 평균이 얼마나 다른가)
- MSE : 집단내 변동 (같은 집단 내 흩어짐 정도)
- F 가 1에 가까울때 : 집단간 차이가 집단내 변동보다 크지 않음
- F 가 클 때 : 집단간 평균 차이가 크다
- 분산분석표
| 구분 | 제곱합 | 자유도 | 평균제곱합 | F |
|---|---|---|---|---|
| 처리 | SSt | k-1 | \(MSt\;=\;SSt\;/\;(k-1)\) | \(F\;=\;MSt\;/\;MSE\) |
| 오차 | SSE | n-k | \(MSE\;=\;SSE\;/\;(n-k)\) | \(F\;=\;MSt\;/\;MSE\) |
| 계 | SST | n-1 |
- 다중 비교 (Multiple Comparison) - Adhoc Analysis
- 사후 비교 방법이라고도 한다.
- 분산분석을 통해 귀무가설을 기각하는 경우 구체적으로 어느 집단간 유의한 차이가 있는가?
- 방법 : 최소유의차 , 튜키의 표준화, 던컨 , 쉐페
| 방법 | 특징 | 장점 | 한계 |
|---|---|---|---|
| 최소유의차(LSD) | 단순 t 검정 여러번 수행 유의수준 보정 거의 없음 |
계산이 가장 단순 검정력 높음 |
제 1종 오류 증가 위험 |
| Turkey HSD | 모든 쌍 비교시 Family-wire error rate 제어 | 안정적, 집단 크기가 비슷할때 강력 | 집단 크기가 다르면 다소 보수적 |
| Scheffe Test | 임의의 선형 대비까지 검정 가능 매우 보수적인 방법 |
가장 안전 (Type 1 error 제어) 집단수 많고 불균형 표본에서도 사용 가능 |
매우 보수적이여서 검정력 낮음 |
Family Wire Error Rate
-
전체 제 1종 오류율
- 여러개의 가설을 동시에 검정할 때 하나라도 잘못 기각 (제 1종 오류) 할 확률 FWER = Pr (At least one Type I eror occurs)
-
예시
- 유의 수준 0.05 에서 평균 비교를 한번만 하면 잘못 기각할 확률 5%
- 5 집단 있으면, 총 5C2 = 10 개의 쌍 발생
- 각각의 10개의 쌍 비교마다 유의수준 0.05 적용 전체 오류 확률은 0.05 보다 커짐
- FWER = \(1 - ( 1 - 0.05 )^{10}\;=\;0.4\)
- 즉, 잘못된 결론이 날 확률까지 40% 상승
이원분산분석법
- 두개의 요인 ( 범주형 변수 ) 의 수치형 변수에서의 영향을 알아보기 위한 연구
- 모형
- 요인 A 의 수준이 a 개, 요인 B 의 수준이 b 일때, 각 집단에서 표본 추출
- \(\mu\) : 전체 평균
- \(\alpha_i\) : 요인 A의 i 수준 주효과
- \(\beta_j\) : 요인 B의 j 수준 주효과
- \((\alpha\beta)_{ij}\) : 요인 A 의 i 수준 과 요인 B 의 j 수준의 교호작용 즉, 서로 상호작용 ex) A 의 수준에 따라 B 의 효과가 달라짐 )
- 제약조건
- 가설
- 요인 A 의 주효과 존재 여부 ( \(H_O\;:\;\alpha_1\;=\;\cdots\;=\;\alpha_a\) )
- 요인 B 의 주효과 존재 여부 ( \(H_O\;:\;\beta_1\;=\;\cdots\;=\;\beta_a\) )
- 요인 A 와 B 의 교호작용 존재 여부
SST = SSA + SSB + SSAB + SSE
- 분산분석표
| 구분 | 제곱합 | 자유도 | 평균제곱합 | F |
|---|---|---|---|---|
| 요인 A | SSA | a-1 | MSA = SSA / (a-1) | MSA/MSE |
| 요인 B | SSB | b-1 | MSB = SSB / (b-1) | MSB/MSE |
| 교호작용 AB | SSAB | (a-1)(b-1) | MSAB = SSAB / (a-1)(b-1) | MSAB/MSE |
| 오차 | SSE | ab(n-1) | MSE = SSE / (ab)(n-1) | |
| 계 | SST | abn-1 |
- 분석 단계
- 모형 설정 및 가정 검토
- 가정 : 정규성 등분산성 독립성
- 교호 작용이 유의하지 않다면 : 교호작용 항 제거 후 모형 단순화
- 사후 검정
- 모형 설정 및 가정 검토
- 교호 작용 그래프
- 두 요인의 평균값을 선으로 연결한 그래프
- X축 요인 A 수준 , Y 축 평균값 , 선타입 : 요인 B 수준
- 두 요인의 평균값을 선으로 연결한 그래프
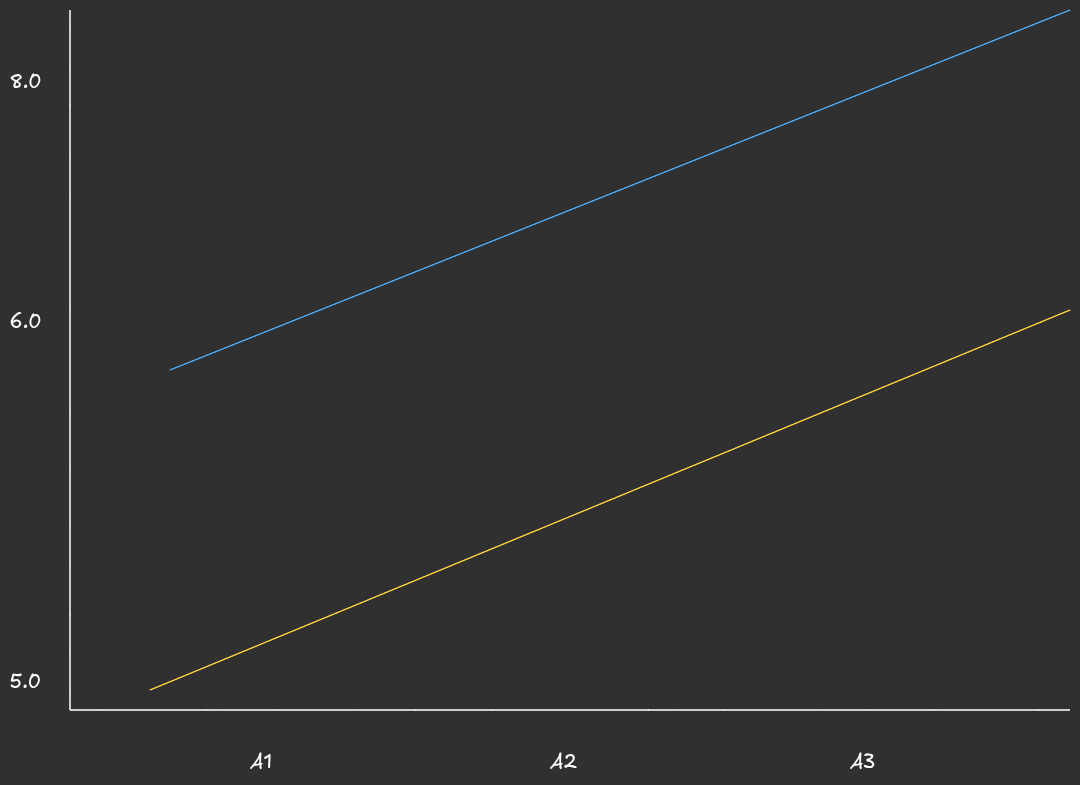 - 평행선 : 교호 작용 없음
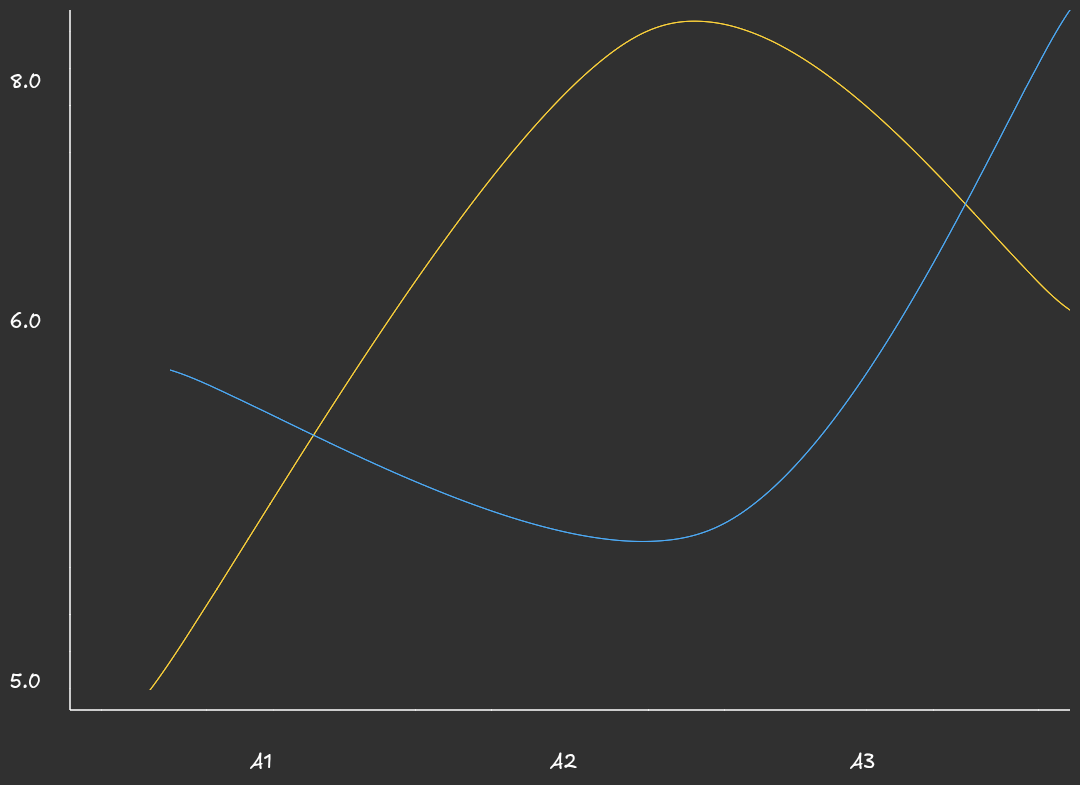 - 선이 교차 : 교호 작용 존재
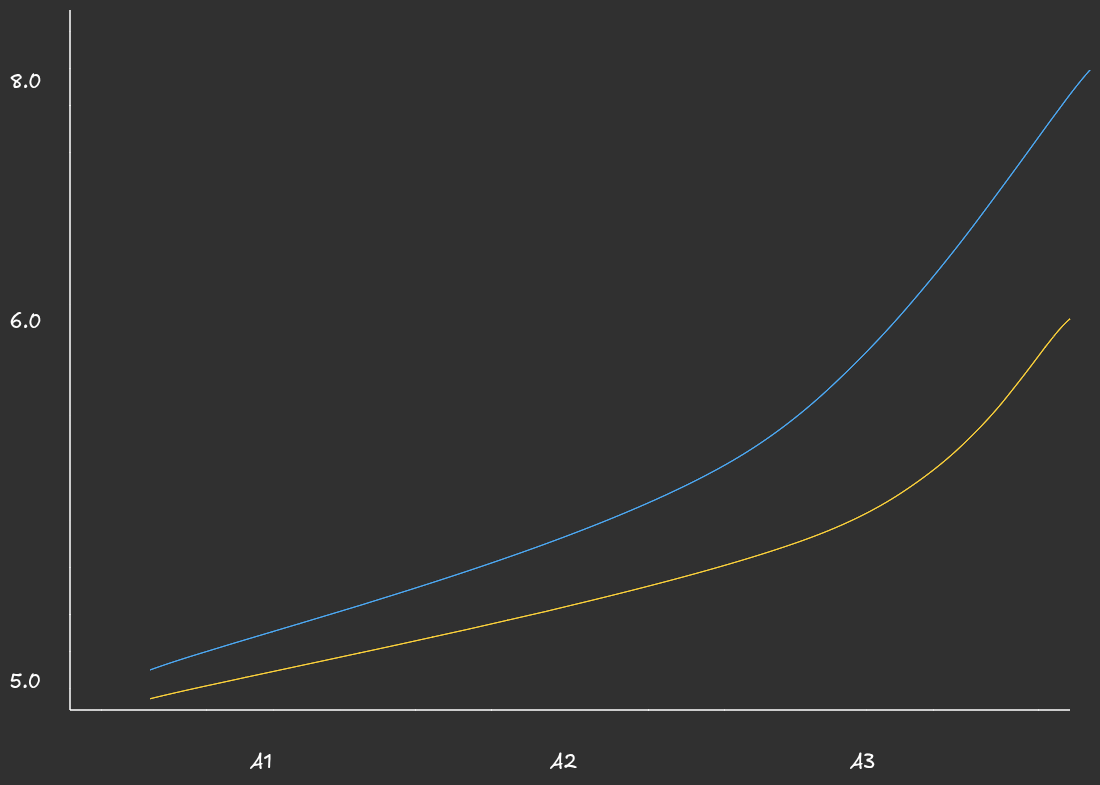 - 선이 벌어지거나 좁아짐 : 교호 작용 존재
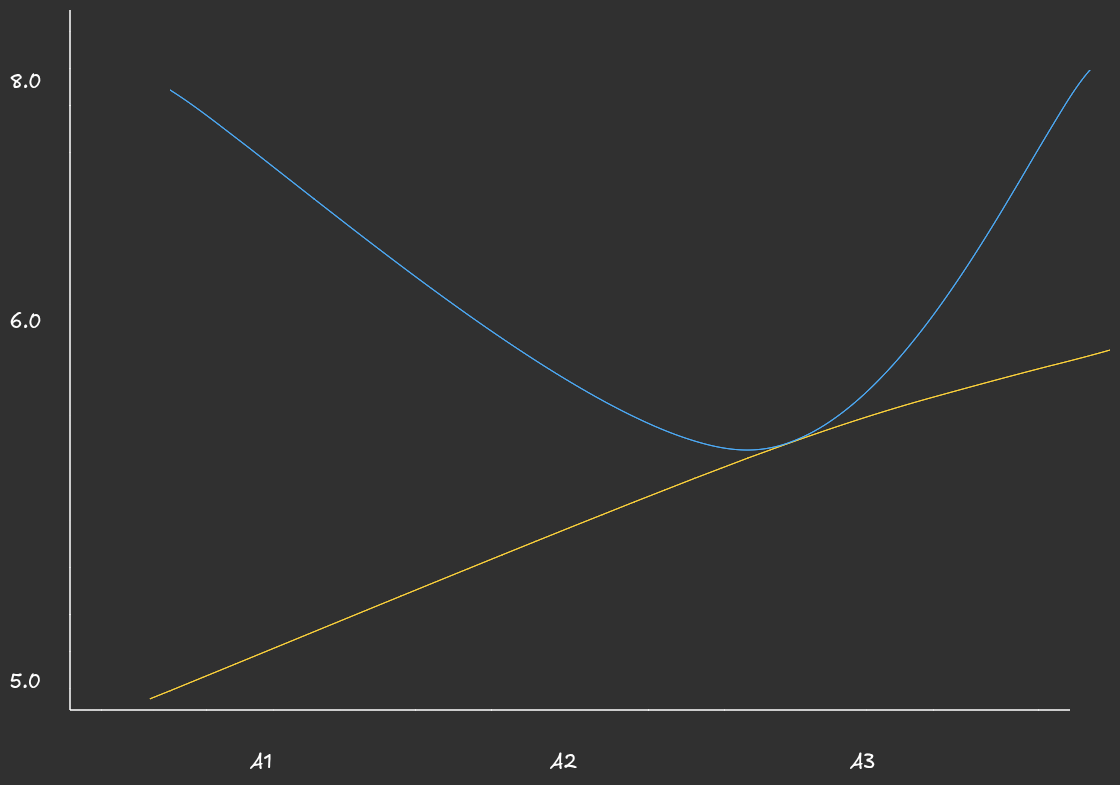 - 교호작용 + 주효과 혼합
- FriedMan 검정 ( 비모수적 이원분산분석 )