Logit Analysis
| ID | 반응변수 | 설명변수 |
|---|---|---|
| 1 | \(y_1\) | \(X_{11},X_{21},\cdots,X_{k1}\) |
| 2 | \(y_2\) | \(X_{12},X_{22},\cdots,X_{k2}\) |
| \(\cdots\) | \(\cdots\) | \(\cdots\) |
| n | \(y_n\) | \(X_{1n},X_{2n},\cdots,X_{kn}\) |
- 범주형 종속변수 (특히 이항) 을 설명하기 위한 방법
- 선형 회귀를 그대로 적용할 수 없으므로, p 를 logit 변환하여 모델링
로지스틱 회귀분석 (Logistic Regression)
- 독립변수 X 가 종속변수 Y \(\in\) {0,1} (이항) 에 미치는 영향을 추정
반응변수가 이항인 경우
- 설명변수 :
- 체중, 나이 등 수치자료
- 처리의 종류 (대조/실험군)
- 종양의 크기 (대/중/소)
- 반응변수 :
- 2개의 가능한 값 (예/아니오, 생존/사망 등)
이항반응 변수의 경우
종속변수는 베르누이 분포를 따른다.
확률분포 식 : y 는 이항분포를 따른다. - \(P(Y=y)\;=\;p^y(1-p)^{1-y}\;,\;y={0,1}\) Y 함수의 기댓값 = 성공으로 정의된 확률변수 p - \(E(Y)\;=\;0\;*\;Pr(Y=0)\;+\;1\;*\;Pr(Y=1)\;=\;Pr(Y=1)\;=\;p\)
반응 변수 Y 의 성공확률(p)에 영향을 미치는 설명변수 X 들을 고려 - \(Y|X\sim \text{Bernoulli}(p_x)\) 확률밀도 함수 - \(P(Y=y|X=x)\;=\;p_x^y(1-p_x)^{1-y},\;y={0,1}\) - 조건부 분포를 쓰는 이유는 특정 설명 변수 X 가 주어졌을때 성공확률이 얼마인지 계산하기 위해
성공확률에 영향을 미치는 설명변수를 고려하는 법
선형 모형
- 성공확률 \(p_x\) 가 0 과 1 을 벗어날 수 있다. (확률 정의 위반)
- 선형회귀 에서 x 값이 변해도 분산은 비슷해야한다. (선형회귀 기본 가정-등분산성 위반) 베르누이 변수의 분산(\(p_x(1-p_x)\))은 x 에 따라 달라진다. 극단 영역에서 둔감, 중간에서 가장 민감하다. 선형 모형에서 발생하는 다양한 문제들을 해결하기 위해 logit 모형(비선형) 을 사용
비선형 모형 (expit 함수) -> (logit 함수)
-
기울기 : \(p_x\) 가 0.5에서 가장 크고 끝으로 갈수록 작아진다. (S자 반응)
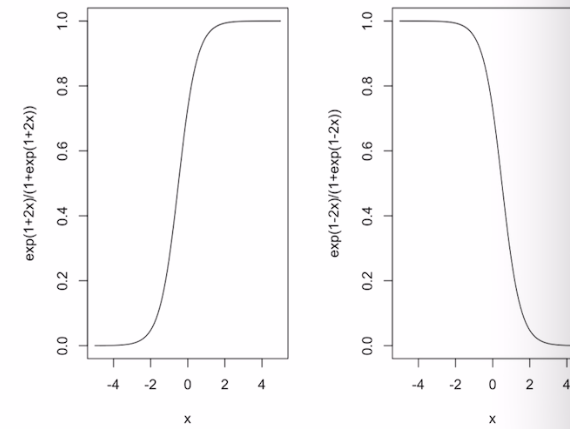
-
\(\beta > 0\) : 증가하는 곡선
- \(\beta = 0\) : 성공확률이 설명변수와 무관
- \(\beta < 0\) : 감소하는 곡선
- 곡선의 변화율은 \(\vert \beta \vert\) 에 비례
- 완만할수록 (유선) \(\beta\) 가 작고
- 급격할수록 (계단) \(\beta\) 가 크다.
x 가 한단위 증가할때는 odds(성공확률/실패확률) 가 \(\exp(\beta)\) 만큼 변한다. \(Y \vert X \approx \text{bernulli}(p_x)\)
- 성공할 오즈(odds)
- 설명변수 x 가 한단위 증가할때마다, 오즈는 \(e^\beta\) 배 증가
- 로그 오즈 ( 로짓 모형 )
- k 개의 설명변수 \(X_1,\cdots,X_k\) 가 있는 로짓 모형
if) \(\beta=0.7\) 이면 odds 약 2배 증가
최대 가능도 추정량 MLE
\(\beta\) 추정
- X=x 가 주어져 있을때, Y 의 조건부 확률 밀도 함수
- \(P(Y=y | X=x)=p_x^y(1-p_x)^{1-y},y=0,1\)
- 로짓 모형
- 가능도 함수
| ID | 반응변수 | 설명변수 |
|---|---|---|
| 1 | \(y_1\) | \(X_{11},X_{21},\cdots,X_{k1}\) |
| 2 | \(y_2\) | \(X_{12},X_{22},\cdots,X_{k2}\) |
| \(\cdots\) | \(\cdots\) | \(\cdots\) |
| n | \(y_n\) | \(X_{1n},X_{2n},\cdots,X_{kn}\) |
각 데이터 행의 발생확률을 모두 곱해주는 것이다. 데이터가 실제로 관측될 확률 최대로 만드는 \(\alpha, \beta\) 로 표현한것이다. -> 뉴튼랩스 등 최적화 방법 을 통해 두 값을 찾는다.
\(\therefore\) 현재 가진 데이터를 가장 잘 설명하는 계수를 찾는 방식
로짓 모형의 검정
- 설명 변수와 연관선
- 회귀 계수의 유의성 검정
- 가설 : \(H_0 : \beta_i = 0\) , \(H_1 : \beta_i \neq 0\)
- 기울기가 0 인지 아닌지
- 효과가 있다 vs 없다.
- 가설 : \(H_0 : \beta_i = 0\) , \(H_1 : \beta_i \neq 0\)
- 오차항에 대한 가정을 쓰지 않는다. ( 오차항이 이항분포의 성질을 따른다. )
- 검정 통계량이 t 분포에서 달라지게 된다.
- Wald 검정 통계량
- if) $\hat p_i = -0.5 , SE = 0.2$
- 검정 통계량 : 0.25
예제 4.1
102 명의 백혈병 환자를 랜덤하게 두개의 그룹으로 나누어서 한 그룹에는 처리 A , 다른 그릅에는 처리 B 를 하여 재발여부를 조사하였다. 이때 재발 여부에 영향을 미칠 수 있는 또 하나의 요인은 호전기간 (remission time)이다. X 는 호전기간(단위 : 월), Y는 재발여부로 재발 안한 경우 Y=0, 재발한 경우 Y=1로 코딩되었다.
분석결과
Response Profile

Ordered Value, y, TotalFrequency
1,1,53
2,0,49

    Probability Modeled is y=1

Class Level Information
            Design Variables
Class, Value, 1
trt, A, 1
     B, -1
- ResponseProfile
- 재발한 그룹 : 53명
- 재발하지 않은 그룹 : 49명
\(\beta_{\text{trt}} < 0\) : A 군에 비해 B 군의 재발 오즈가 크다. \(\beta_{\text{trt}} > 0\) : B 군에 비해 A 군의 재발 오즈가 크다.
모형의 적합성
- Deviance : 우도비 카이제곱 통계량
- Pearson : 피어슨 카이제곱 통계량
- DF : 처리범주 x 호전 기간 범주 - 추정해야 하는 모수 수
- P-val > 유의수준 : 고려하는 로짓 모형이 자료에 적합하다.
Deviance and Pearson Goodness-of-Fit Statistics

Criterion   DF    Value    Value/DF    Pr>ChiSq

Deviance    9      4.8181     0.5353     0.8499
Pearson     9      3.3468     0.3719     0.9489
모수들의 추정 값과 검정통계량
- \(\ln{p_x \over 1-p_x}\;=\;2.04-0.59trt-0.20remission\)
- 처리 A \({P_x(A) \over 1-P_x(A)}\) : \(\exp(2.04 - 0.59 - 0.20remission)\)
- 처리 B \({P_x(B) \over 1-P_x(B)}\) : \(\exp(2.04 + 0.59 -0.20remission)\)
- 호전기간 고정 후 처리 A 와 처리 B 의 오즈비
- \({{P_x(A) \over 1 - P_x(A)}\over {P_x(B) \over 1-P_x(B)}}\;=\;\exp(-0.59*2)=0.308\)
The LOGISTIC Precedure
Analysis of Maximum Likelihood Estimates

Parameter    DF    Estimate    SE    Wald Chi-Square    Pr > ChiSq

Intercept     1      2.0445   0.5945    11.8266      0.0006
trtA          1     -0.5887   0.2334     6.3652      0.0116
remission     1     -0.1998   0.0559    12.7824      0.0003
다항반응 변수의 경우
- 순서형 반응 변수의 경우
- 비례 오즈 (Proportional Odds) 로짓 모형 조건 : 모든 범주구간에 대해 같은 계수를 공유한다.
반응변수 \(Y\) 가 \(J\) 개의 순서형 범주를 갖고 설명변수가 \(k\) 개 일때 \(i\) 번째 개체의 설명변수 벡터 \(x_i={x_{i1},x_{i2},\cdots,x_{ik}}\) 에 대하여 \(\pi_{ij}\) 를 \(i\) 번째 개체가 \(j\) 번째 반응을 나타낼 확률
\(j\) 번째 누적확률은 반응변수 \(Y\) 가 범주 \(j\) 이하에 해당할 확률로 다음과 같이 정의한다.
따라서 누적 로짓 은 다음과 같이 정의된다.
위 누적 로짓 모형에 설명변수 \(x_i\) 의 효과를 포함하여 아래와 같은 모형을 나타낸다.
여기서 \(\beta\) 는 \(\beta=(\beta_1,\cdots,\beta_k)'\) 으로 표현되고 \(J-1\) 의 범주에 공통적으로 적용되는 벡터이다. 이것은 비례오즈 모형의 기본 가정이 된다. 이 식을 다시 쓰면
- 이웃 범주 (Adjacent-Categories) 로짓 모형
-
연속비 (Continuation-Ratio) 로짓 모형
-
명목형 반응 변수의 경우
- 일반화 (Generalized) 로짓 모형 -> 기준범주를 정하여 나머지 범주와 비교한다.
비례오즈에서 조건이 깨질 경우 일반화 로짓 모형을 선택한다.
비례 오즈 로짓 모형
- Y. J 개의 순서형 범주를 가지고 있는 반응 변수
- (\(X_1\),\(\cdots\),\(X_K\)) : 설명변수 k개
- \(x_i = (x_{i1},x_{i2},\cdots,x_{ij})^T\)
- \(\pi_{ij}\;=\;Pr(Y=j|X=x_i)\) : i 번째 개체가 j 번)재 반응을 나타낼 확률
- i 번째 개체가 j 번째 반응까지의 누적 확률
- \(F_{ij} = P(Y \leq j | X = x_i) = \pi_{i1} + \pi_{i2} + \cdots + \pi_{ij},\quad j=\{1,\cdots,j\}\)
모형
- 누적 로짓 (Cumulative Logit)
- 비례 가정이 만족되지 않으면 일반화 로짓 모형으로 적합
예제. 순서형 반응변수 - 비례 오즈 로짓 모형
관절염 통증 - 남성과 여성을 2가지 처리 방법에 할당하여 통증의 개선 정도를 1) 전혀없음, 2) 약간 있음, 3) 상당히 있음 3가지의 순서형 반응으로 측정하였다. 통증의 개선도가 성별과 처리 방법에 따라 영향을 받는지 알아보고자 한다.
| 성별 | 처리 | 개선도(전혀없음) | 개선도(약간있음) | 개선도(상당히있음) | 합 |
|---|---|---|---|---|---|
| 여 | A | 6 | 5 | 16 | 27 |
| 여 | P | 19 | 7 | 6 | 32 |
| 남 | A | 7 | 2 | 5 | 14 |
| 남 | P | 10 | 0 | 1 | 11 |
- 비례오즈 로짓모형의 비례오즈 가정 : 즉, 범주들에 대해 설명변수의 효과가 동일
- p > 0.05 : 비례 오즈 가정 만족
- Deviance, Pearson 모두 p > 0.05 : 모형이 자료에 잘 적합됨
- \(logit[F_{i1}] = 0.2547 - 0.6593x_{i1} - 0.8972x_{i2},j = 1\)
- \(logit[F_{i2}] = 1.1091 - 0.6593x_{i1} - 0.8972x_{i2},j = 2\) - \(x_{i1} : 성별, x_{i2} : 처리\)
Analysis of Maximum Likelihood Estimates

Parameter    DF    Estimate    SE    Wald Chi-Square    Pr>ChiSq

Intercept n   1     0.2547    0.2685     0.8999    0.3428
Intercept s   1     1.1091    0.2949    14.1434    0.0002
gender f      1    -0.6593    0.2646     6.2096    0.0127
trt a         1    -0.8987    0.2364    14.4493    0.0001
Odds Ratio Estimates

Effect          Point Estimate     95% Wald Confidence Limits
gender f vs m     0.267            0.095     0.755
trt    a vs p     0.166            0.066     0.419
명목형 반응변수 - 일반화 로짓 모형
- 기준 범주 로짓
예제
- 성별과 인종에 따라 어떤 정당을 지지하는 가를 조사하였다.
- 반응변수는 지지하는 정당 (민주당 - D, 공화당 - R, 무소속 - I)