공분산 분석
2
| 관측번호 | 교육방법 | X | Y |
|---|---|---|---|
| 1 | 1 | 29 | 39 |
| 2 | 1 | 4 | 34 |
| 3 | 1 | 18 | 36 |
| 4 | 2 | 17 | 35 |
| 5 | 2 | 35 | 38 |
| 6 | 2 | 3 | 32 |
| 7 | 3 | 1 | 38 |
| 8 | 3 | 15 | 43 |
| 9 | 3 | 32 | 44 |
반응 변수 : 교육 방법 적용 후 시험 성적 (수치형) 설명 변수 : 교육 방법의 종류 (범주형), 초기 시험 성적 (수치형)
연구 문제
- 교육방법의 차이를 감안한 상태에서 초기 시험 성적이 적용 후 시험 성적에 영향을 미치는가?
- 초기 시험 성적을 감안한 상태에서 교육 방법에 따라 적용 후 시험 성적에 차이가 있는가?
가설 설정
- \(H_{01}\) : \(\beta = 0\) (공변량의 효과가 0이다.)
- \(H_{02}\) : \(\alpha_1=\alpha_2=\alpha_3\)
데이터 탐색
기초 통계량
| Method | 개수 | 평균 | 중앙값 | 표준편차 | 최솟값 | 최댓값 |
|---|---|---|---|---|---|---|
| 1 | 3 | 17.0 | 18 | 12.53 | 4 | 29 |
| 2 | 3 | 18.3 | 17 | 16.04 | 3 | 35 |
| 3 | 3 | 16.0 | 15 | 15.52 | 1 | 32 |
| Method | 개수 | 평균 | 중앙값 | 표준편차 | 최솟값 | 최댓값 |
|---|---|---|---|---|---|---|
| 1 | 3 | 36.3 | 36 | 2.52 | 34 | 39 |
| 2 | 3 | 35.0 | 35 | 3.00 | 32 | 38 |
| 3 | 3 | 41.7 | 43 | 3.21 | 38 | 44 |
Scatter-Box plot
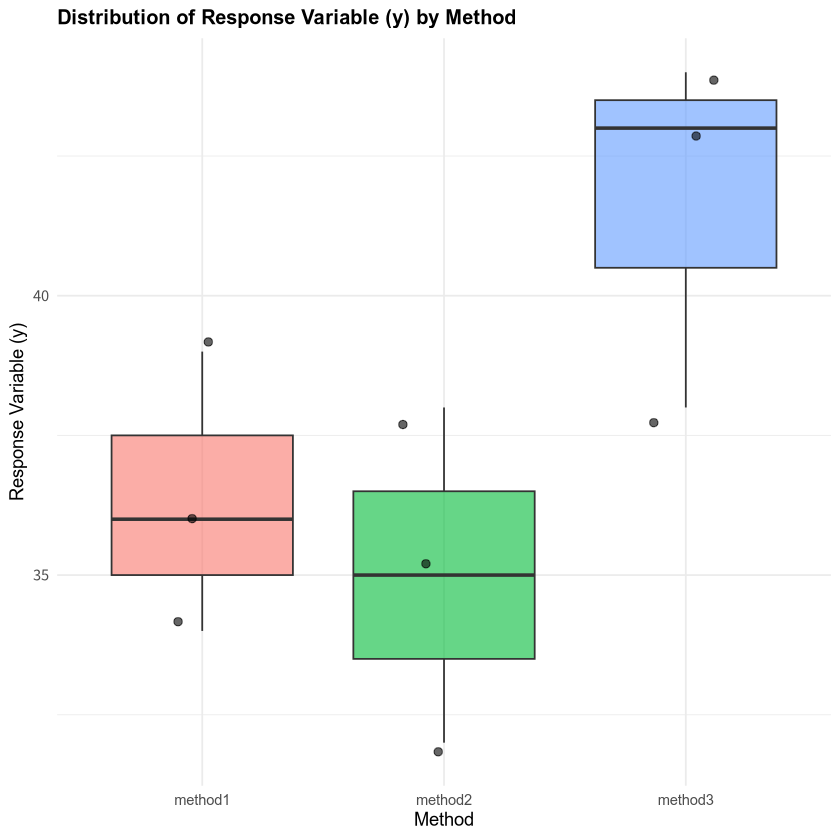
회귀선
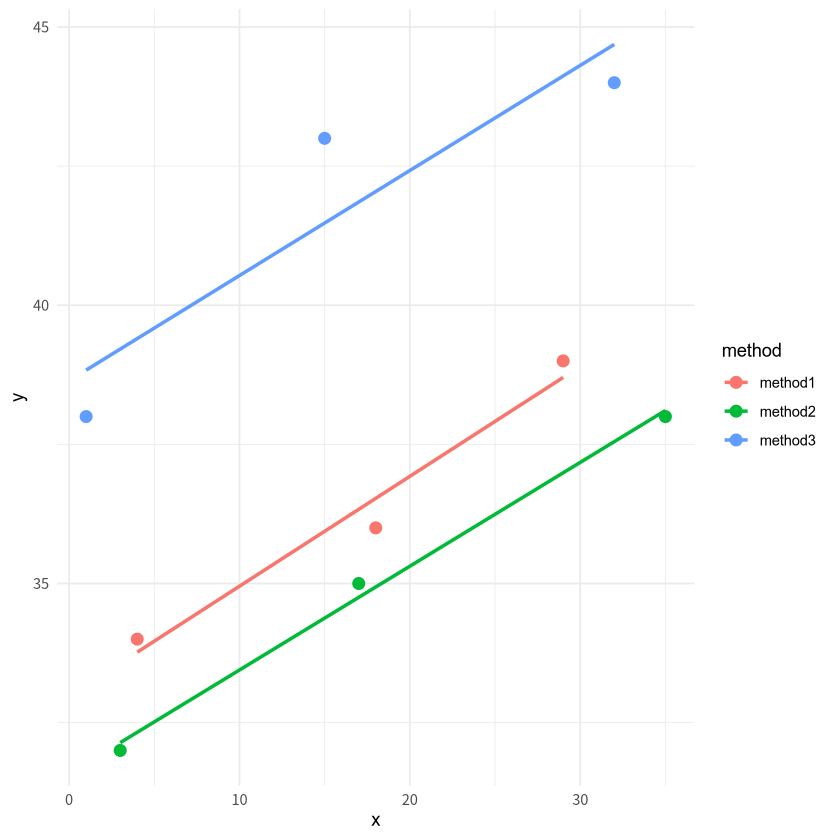
분석 결과
교호작용 검정
Anova(lm(y ~ x * method, data=data), Type="3")
| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 867.3891 | 1 | 649.8820 | < 0.0001 |
| x | 12.2420 | 1 | 9.1722 | 0.0010 |
| method | 30.2470 | 2 | 11.3311 | 0.0400 |
| method*x | 0.0243 | 2 | 0.0091 | 0.9910 |
| Residuals | 4.0041 | 3 | NA | NA |
F 검정 결과 F 값은 0 에 가깝고 p 값은 0.9910 이므로 유의수준 0.05 에서 유의하지 않다. 따라서 초기 시험성적(공변량) 과 교육방법(처리) 사이에 교호작용이 존재하지 않으므로 공분산 분석을 진행하였다.
공분산 분석표 (제 3종 제곱합)
Anova(lm(y ~ x + method, data=data), Type="3")
| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 1978.6758 | 1 | 2455.9081 | < 0.001 |
| x | 47.3049 | 1 | 58.7143 | < 0.001 |
| method | 83.1307 | 2 | 51.5904 | < 0.001 |
| Residuals | 4.0284 | 5 | NA | NA |
제 3종 제곱합은 \(SS(x\;|\;method) + SS(method\;|\;x)\) 가 된다. F 값 51.59, p 값이 유의수준 0.05 에서 매우 작으므로, 따라서 Method 의 효과는 초기 수치를 보정했을때, 유의하다는 것을 의미한다.
초기 시험성적에 대한 p 값은 매우 작으므로 유의수준 0.05 에서 초기 시험성적에 대한 효과가 0이라는 위 연구문제의 \(H_{01}\) 귀무가설을 기각한다.
모수 추정치 결과
summary(lm(y ~ x + method, data=data))
| Estimate | Std. Error | t | p | |
|---|---|---|---|---|
| Intercept | 33.1037 | 0.6680 | 49.557 | < 0.001 |
| x | 0.1900 | 0.0248 | 7.663 | 0.0006 |
| Method 2 | -1.5866 | 0.7336 | -2.163 | 0.0829 |
| Method 3 | 5.5233 | 0.7333 | 7.532 | 0.0007 |
교육 방법 1을 기준으로 유의수준 0.05에서 교육방법 2에 차이에 대한 p 값이 0.0829 로 유의하지 않음으로 차이가 없다. 또한 교육 방법 1을 기준으로 유의수준 0.05에서 교육방법 3에 차이에 대한 p 값이 0.0007 로 유의함으로 차이가 있다.
잔차 등분산성 검정
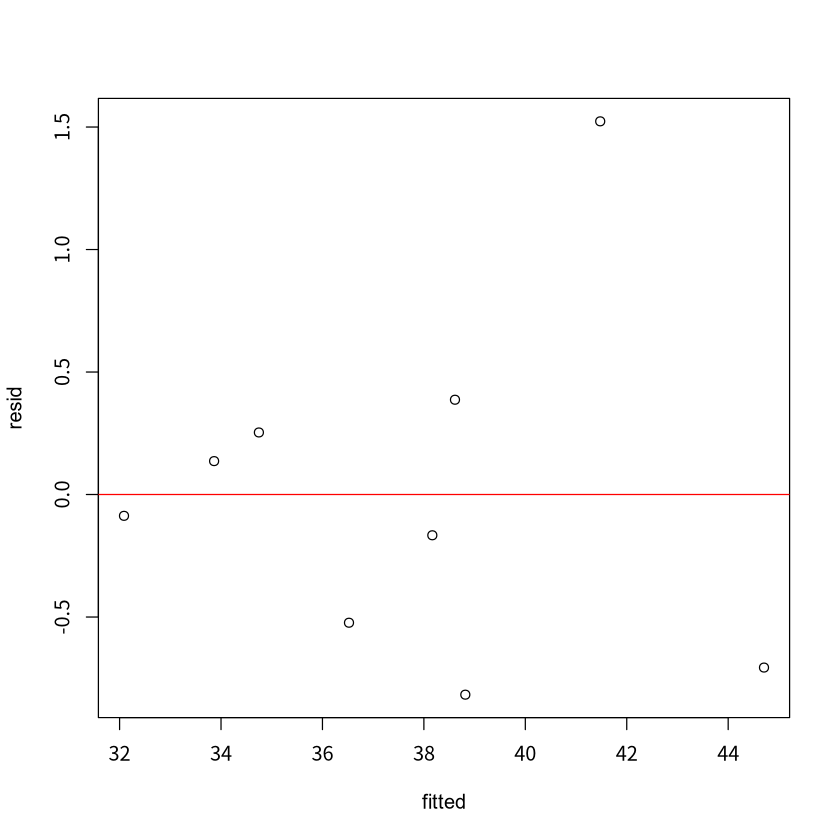 잔차에 대한 등분산 검정을 시행한 결과 p 값이 0.5892 이므로 유의수준 0.05 에서
등분산성을 만족한다.
잔차 정규성 검정
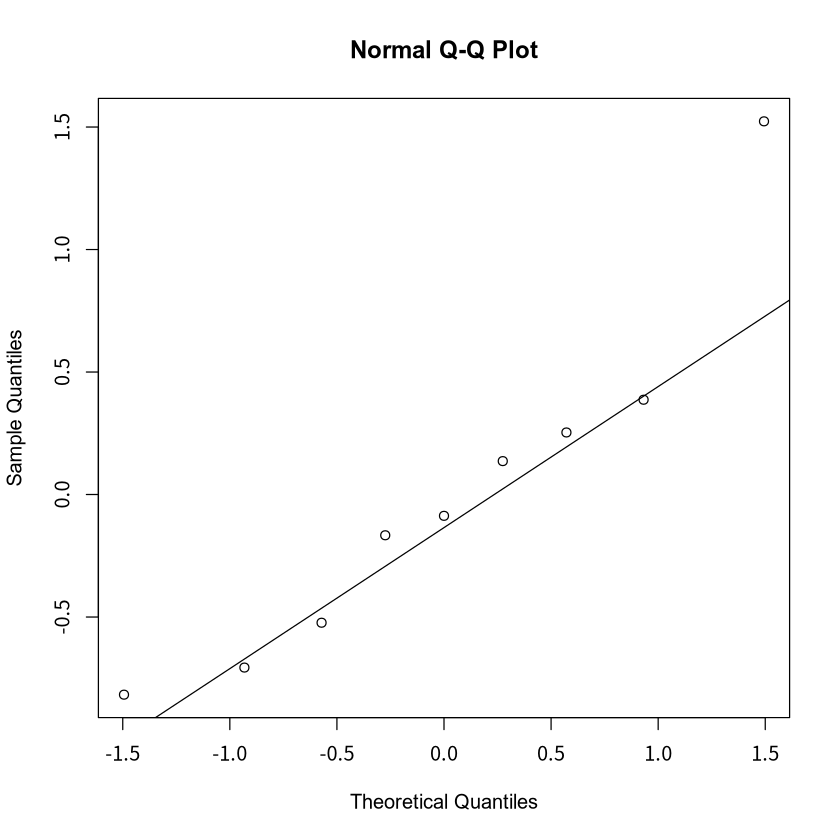 잔차에 대한 정규성 검정을 시행한 결과 p 값이 0.3173 이므로 유의수준 0.05 에서
정규성을 만족한다.
보정 평균
앞서 구한 각 교육방법의 회귀식에서 공변량의 전체 평균값을 넣어 교육방법 별 보정된 평균을 위와 같이 계산하였다.
사후검정 (Tukey)
| Contrast | Estimate | SE | df | t Ratio | p |
|---|---|---|---|---|---|
| Method 1 - 2 | 1.59 | 0.734 | 5 | 2.163 | 0.1714 |
| Method 1 - 3 | -5.52 | 0.733 | 5 | -7.532 | 0.0015 |
| Method 2 - 3 | -7.11 | 0.735 | 5 | -9.671 | 0.0005 |
유의수준 0.05 하에서 교육방법 1 - 2의 p 값이 0.1714 이므로 적용후 시험성적의 평균에 차이가 없고 교육방법 1 - 3 , 2 - 3 이 각각 0.015, 0.005 의 p 값을 가지므로 적용후 시험성적의 평균에 차이가 있다.
# 3
| 관측번호 | 치료약 | X | Y |
|---|---|---|---|
| 1 | A | 11 | 6 |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) |
| 10 | A | 3 | 0 |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) |
| 19 | B | 5 | 1 |
| 20 | B | 15 | 9 |
| 21 | C | 16 | 13 |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) |
| 30 | C | 12 | 20 |
반응 변수 : 실험 후 나병균 개수 (수치형) 설명 변수 : 치료약 (범주형), 실험 전 나병균 개수 (수치형)
연구 문제
- 치료약의 차이를 감안한 상태에서 실험 전 나병균 개수가 실험 후 나병균 개수에 영향을 미치는가?
- 실험 전 나병균 개수를 감안한 상태에서 치료약에 따라 실험 후 나병균 개수에 차이가 있는가?
가설 설정
- \(H_{01}\) : \(\beta = 0\)
- \(H_{02}\) : \(\alpha_1=\alpha_2=\alpha_3\)
데이터 탐색
기초 통계량
| 실험 전 나병균 수 | 개수 | 평균 | 중앙값 | 표준편차 | 최솟값 | 최댓값 |
|---|---|---|---|---|---|---|
| A | 10 | 9.3 | 9 | 4.76 | 3 | 19 |
| B | 10 | 10.0 | 8 | 5.25 | 5 | 19 |
| C | 10 | 12.9 | 12 | 3.96 | 7 | 21 |
| 실험 후 나병균 수 | 개수 | 평균 | 중앙값 | 표준편차 | 최솟값 | 최댓값 |
|---|---|---|---|---|---|---|
| A | 10 | 5.30 | 5.0 | 4.64 | 0 | 13 |
| B | 10 | 6.10 | 3.5 | 6.15 | 0 | 18 |
| C | 10 | 12.3 | 12.5 | 7.15 | 1 | 23 |
Scatter-Box plot
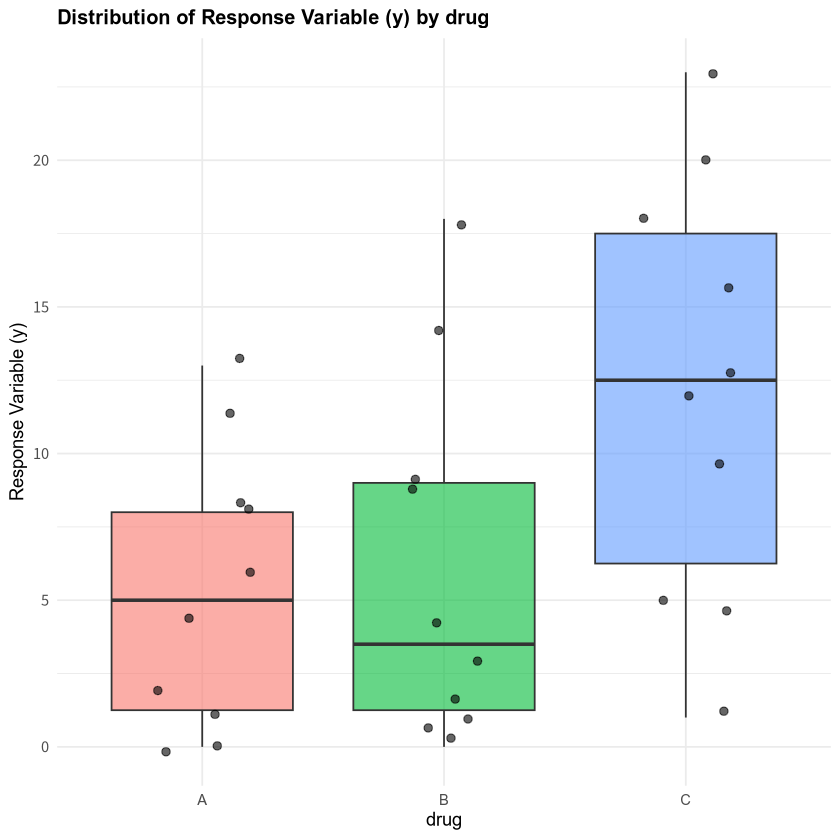
회귀선
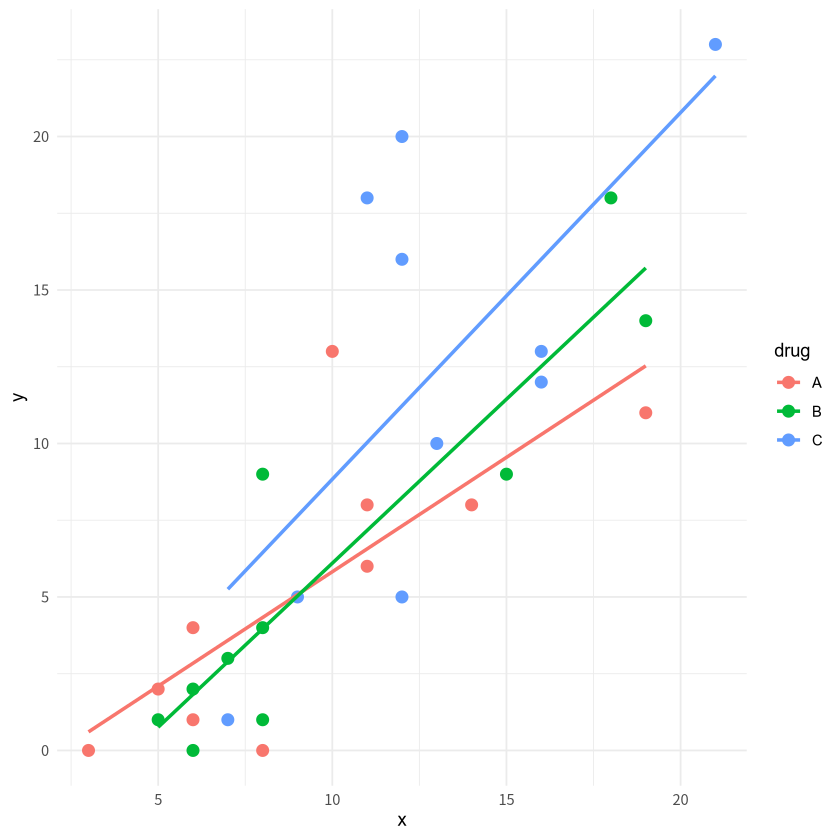
분석 결과
교호작용 검정
| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 5.076 | 1 | 0.3064 | 0.5850 |
| x | 113.348 | 1 | 6.8427 | 0.0152 |
| drug | 8.503 | 2 | 0.2566 | 0.7757 |
| drug:x | 19.645 | 2 | 0.5930 | 0.5606 |
| Residuals | 397.558 | 24 | NA | NA |
F 검정 결과 F 값은 0.5930, p 값은 0.5606 이므로 유의수준 0.05 에서 유의하지 않다. 따라서 실험 전 나병균 수(공변량) 와 치료약(처리) 사이에 교호작용이 존재하지 않으므로 공분산 분석을 진행하였다.
공분산 분석표 (제 3종 제곱합)
| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 61.260 | 1 | 3.818 | < 0.0001 |
| x | 577.897 | 1 | 36.015 | < 0.0001 |
| drug | 68.554 | 2 | 2.136 | < 0.0001 |
| Residuals | 417.203 | 26 | NA | NA |
제 3종 제곱합은 \(SS(x\;|\;drug) + SS(drug\;|\;x)\) 가 된다. F 값 2.136, p 값이 유의수준 0.05 에서 매우 작으므로, 따라서 Drug 의 효과는 초기수치를 보정했을때, 유의하다는 것을 의미한다.
실험 전 나병균 수 에 대한 p 값은 매우 작으므로 유의수준 0.05 에서 실험 전 나병균 수 에 대한 효과가 0이라는 위 연구문제의 \(H_{01}\) 귀무가설을 기각한다.
모수 추정치 결과
| Estimate | Std. Error | t | p | |
|---|---|---|---|---|
| Intercept | -3.8808 | 1.9862 | -1.954 | 0.0616 |
| x | 0.9872 | 0.1645 | 6.001 | < 0.001 |
| drugB | 0.1090 | 1.7951 | 0.061 | 0.9521 |
| drugC | 3.4461 | 1.8868 | 1.826 | 0.0793 |
치료약 A를 기준으로 유의수준 0.05에서 치료약 B의 차이에 대한 p 값이 0.9521 로 유의하지 않음으로 차이가 없다. 또한 치료약 A를 기준으로 유의수준 0.05에서 치료약 C의 차이에 대한 p 값이 0.0793 로 유의하지 않음으로 차이가 없다.
잔차 등분산성 검정
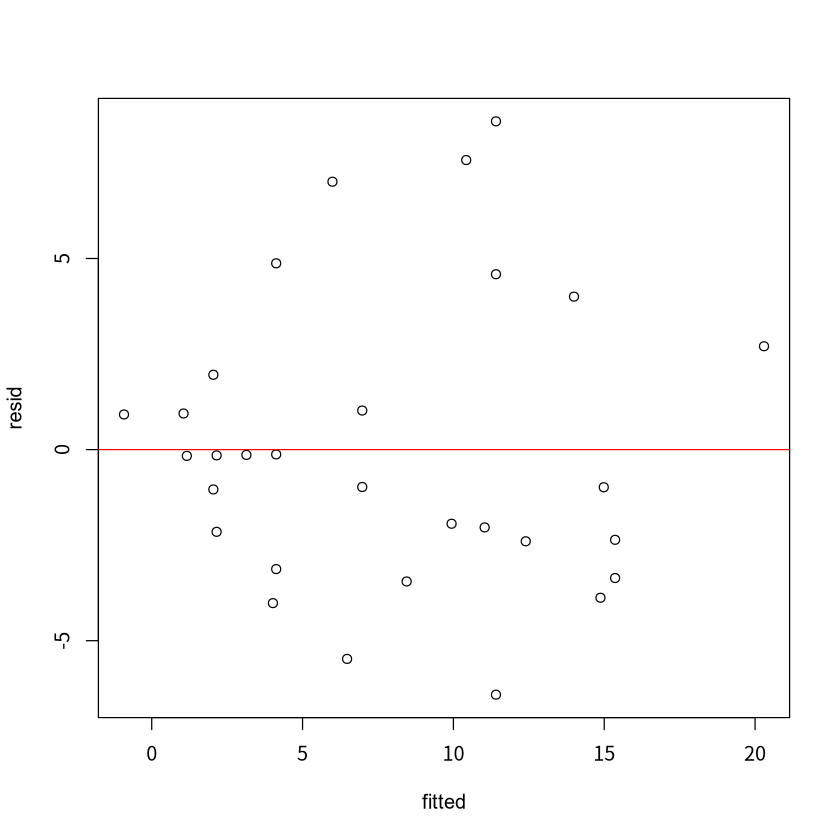
잔차에 대한 등분산 검정을 시행한 결과 p 값이 0.1318 이므로 유의수준 0.05 에서 등분산성을 만족한다.
잔차 정규성 검정
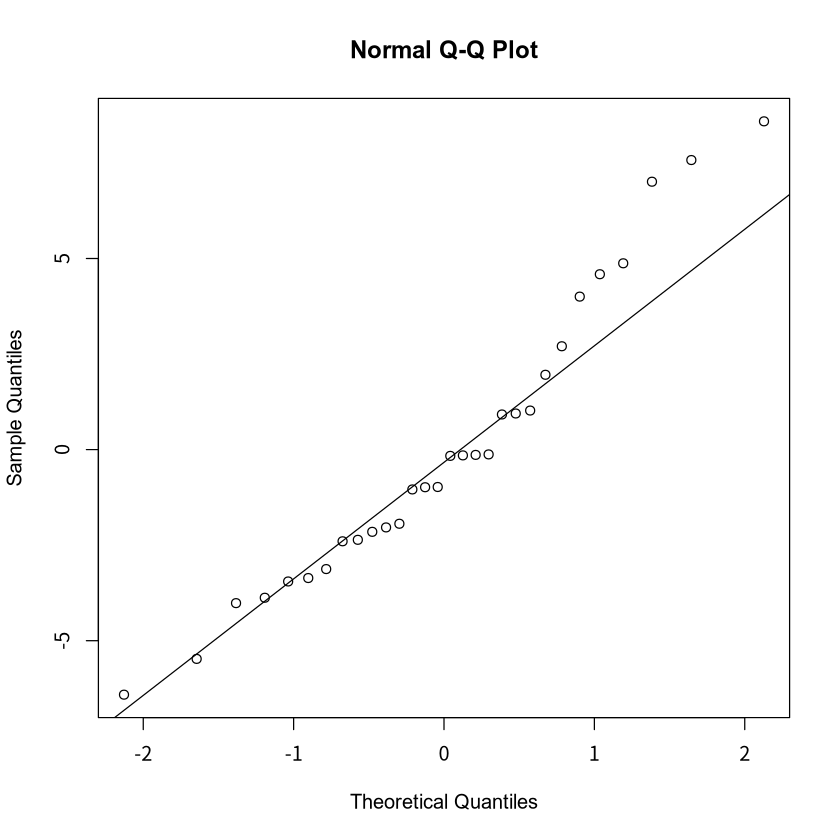
잔차에 대한 정규성 검정을 시행한 결과 p 값이 0.1708 이므로 유의수준 0.05 에서 정규성을 만족한다.
보정 평균
앞서 구한 각 교육방법의 회귀식에서 공변량의 전체 평균값을 넣어 교육방법 별 보정된 평균을 위와 같이 계산하였다.
사후검정 (Tukey)
| Contrast | Estimate | SE | df | t Ratio | p |
|---|---|---|---|---|---|
| Drug A - B | -0.109 | 1.80 | 26 | -0.061 | 0.9980 |
| Drug A - C | -3.446 | 1.89 | 26 | -1.826 | 0.1809 |
| Drug B - C | -3.337 | 1.85 | 26 | -1.800 | 0.1893 |
유의수준 0.05 하에서 모든 경우의 p 값이 > 0.05 이므로 차이가 없다.
7
| 관측번호 | 수업 방법 | 지능 | 동기 | 성취 |
|---|---|---|---|---|
| 1 | 전통적 | 99 | 12 | 58 |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) |
| 20 | 전통적 | 113 | 13 | 63 |
| 21 | 수준별 | 95 | 12 | 58 |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) |
| 40 | 수준별 | 114 | 14 | 60 |
| 41 | 혼합형 | 94 | 12 | 59 |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) |
| 60 | 혼합형 | 112 | 13 | 64 |
반응 변수 : 수업 성취도 (수치형) 설명 변수 : 수업 방법 (범주형), 지능 (수치형), 동기 (수치형)
연구 문제
- 수업 방법의 차이를 제어한 상태에서 지능과 동기의 효과가 있는가?
- 지능과 동기의 효과를 제어한 상태에서 수업 방법에 따라 수업 성취도에 차이가 있는가?
가설 설정
- \(H_{01}\) : \(\beta_1 = 0\quad\text{OR}\quad\beta_2=0\)
- \(H_{02}\) : \(\alpha_1=\alpha_2=\alpha_3\)
데이터 탐색
기초 통계량
| 지능 | 개수 | 평균 | 중앙값 | 표준편차 | 최솟값 | 최댓값 |
|---|---|---|---|---|---|---|
| 전통적 | 20 | 104.1 | 103.0 | 40.63 | 95 | 113 |
| 수준별 | 20 | 105.7 | 105.5 | 5.47 | 95 | 114 |
| 혼합형 | 20 | 103.8 | 104.0 | 5.36 | 94 | 112 |
| 동기 | 개수 | 평균 | 중앙값 | 표준편차 | 최솟값 | 최댓값 |
|---|---|---|---|---|---|---|
| 전통적 | 20 | 12.85 | 13 | 0.88 | 11 | 15 |
| 수준별 | 20 | 13.15 | 13 | 0.75 | 12 | 14 |
| 혼합형 | 20 | 13.25 | 13 | 0.97 | 11 | 15 |
| 성취 | 개수 | 평균 | 중앙값 | 표준편차 | 최솟값 | 최댓값 |
|---|---|---|---|---|---|---|
| 전통적 | 20 | 59.65 | 59.5 | 2.56 | 55 | 64 |
| 수준별 | 20 | 60.30 | 60.5 | 2.87 | 55 | 65 |
| 혼합형 | 20 | 61.60 | 62 | 2.70 | 56 | 66 |
Scatter-Box plot
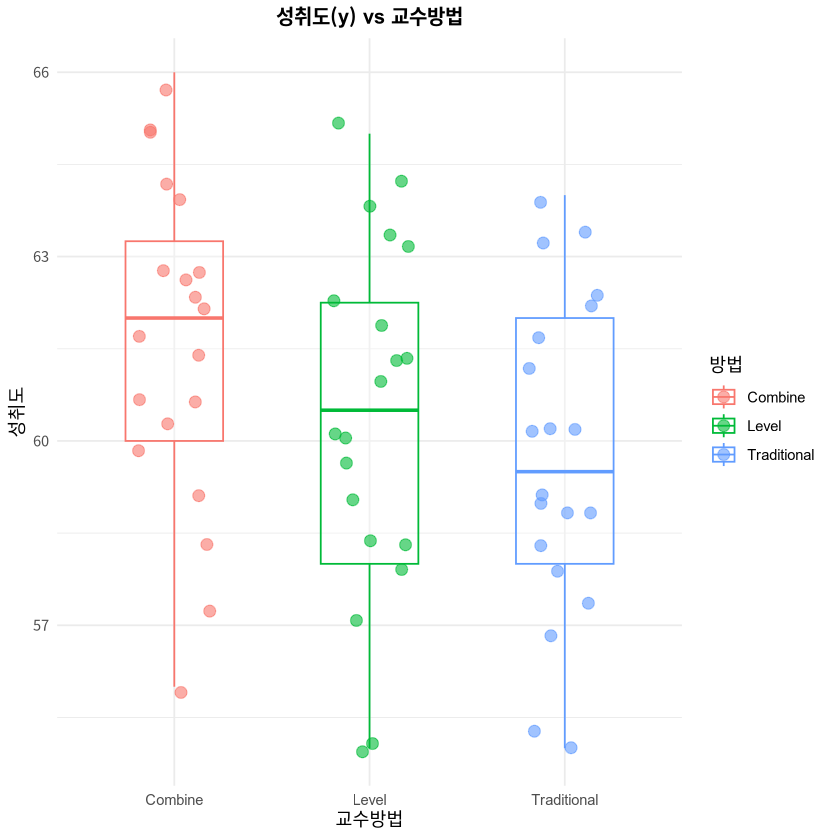
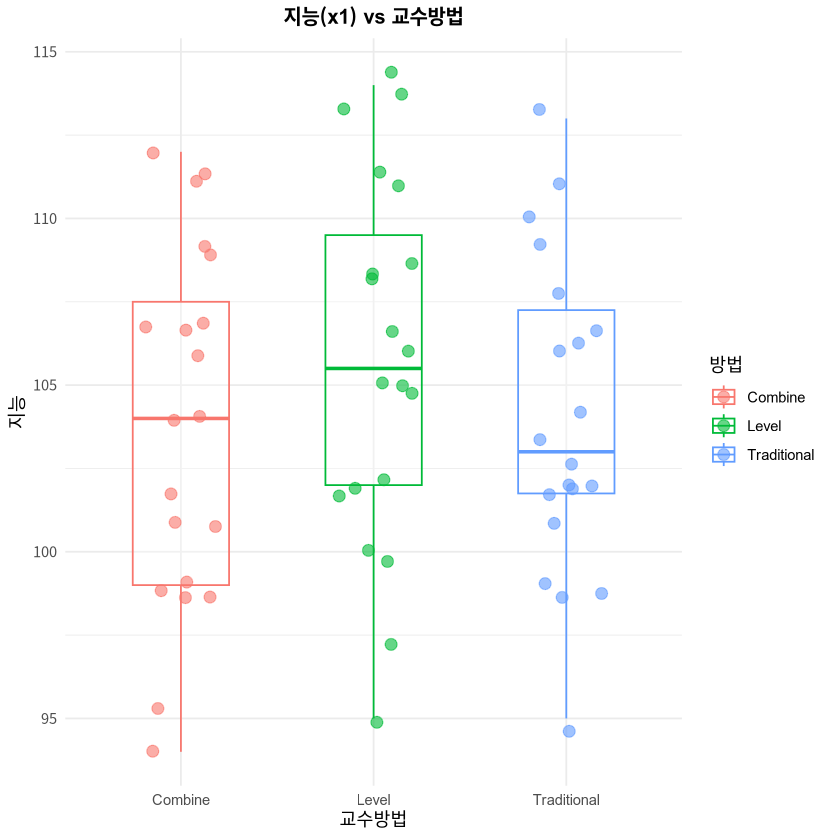
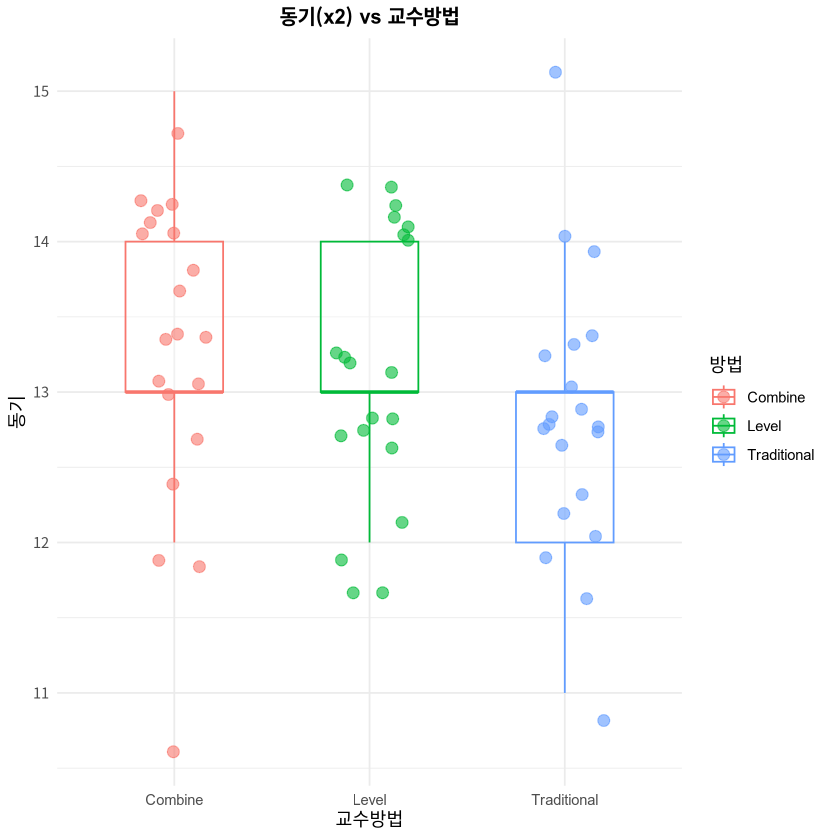
회귀선
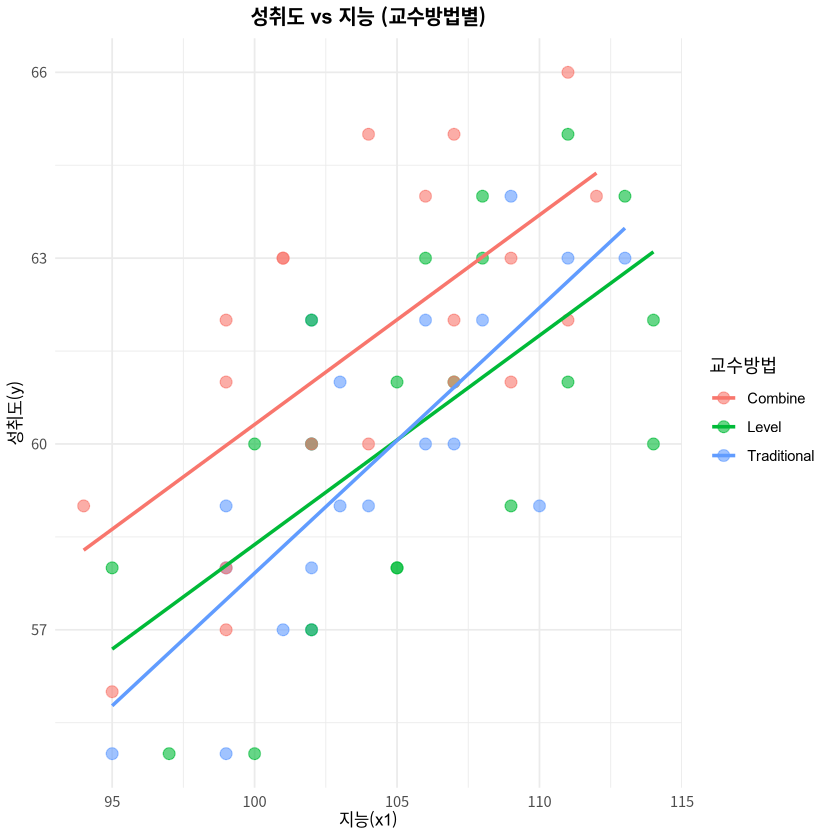
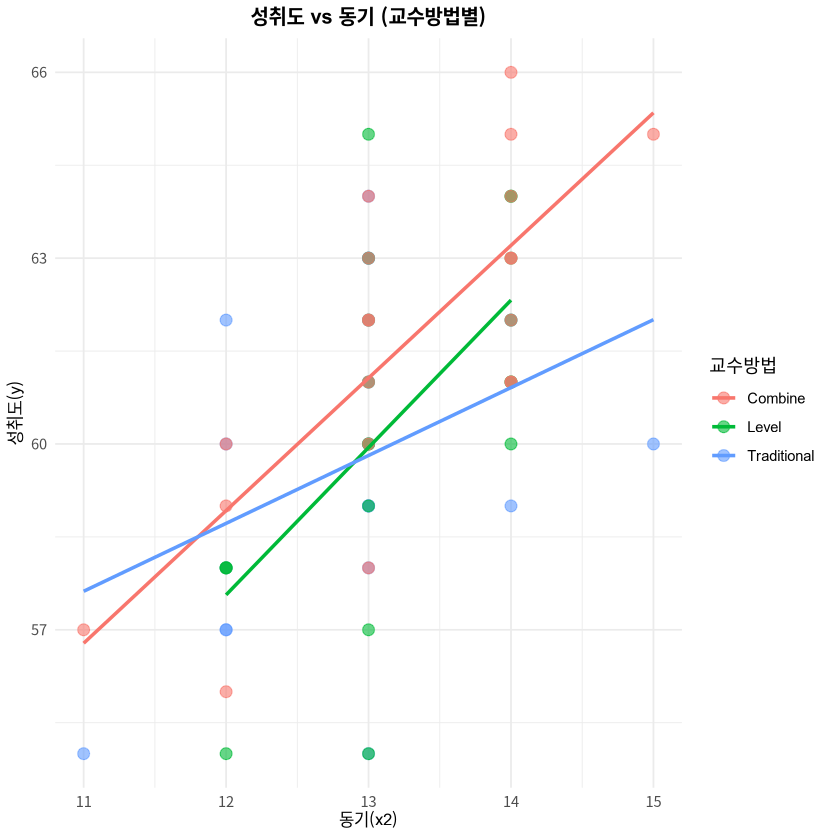
분석 결과
교호작용 검정
model1 = lm(y ~ Methods + Methods*x1 + Methods*x2, data=data)
Anova(model1, type="3")
| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| x1 (지능) | 13.004 | 1 | 3.9429 | 0.0525 |
| x2 (동기) | 31.987 | 1 | 9.6990 | 0.0030 |
| Methods | 1.451 | 2 | 0.2200 | 0.8033 |
| Methods:x1 | 10.144 | 2 | 1.5379 | 0.2246 |
| Methods:x2 | 11.443 | 2 | 1.7348 | 0.1867 |
| Residuals | 168.199 | 51 | NA | NA |
-
지능(\(x_1\)) 과 수업 방법 (Methods)간 나타난 교호작용의 F 값은 1.5379 p 값 0.2246 으로 유의수준 0.05 에서 유의하지 않다.
-
동기(\(x_2\)) 와 수업 방법 (Methods)간 나타난 교호작용의 F 값은 1.7348 p 값 0.1867 으로 유의수준 0.05 에서 유의하지 않다.
따라서, 두 공변량과 수업 방법에 교호작용이 존재하지 않으므로 공분산 분석을 진행 할 수 있다.
공분산 분석표 (제 3종 제곱합)
model2 = lm(y ~ Methods + x1 + x2, data=data)
Anova(model2, type="3")
| Sum Sq | Df | F value | Pr(>F) | |
|---|---|---|---|---|
| (Intercept) | 45.04713 | 1 | 13.5069 | < 0.0001 |
| x1 | 90.28584 | 1 | 27.0712 | < 0.0001 |
| x2 | 36.75239 | 1 | 11.0198 | < 0.0001 |
| Methods | 34.96521 | 2 | 5.2420 | < 0.0001 |
| Residuals | 183.43213 | 55 | NA | NA |
제 3종 제곱합은 \(SS(x_1\;|\;method,x_2) + SS(method\;|\;x_1,x_2) + SS(x_2\;|\;method,x_1)\) 된다.
두 공변량을 보정한 수업 방법의 효과에 대한 F 값은 5.242 이고 p 값이 유의수준 0.05 에서 매우 작으므로 유의하게 나타나난다. 즉, 지능(\(x_1\))과 동기(\(x_2\))를 제어했을때 수업 방법에 따라 성취(y) 가 유의하게 다르다고 보여진다. 또한 지능(\(x_1\)) 은 F 값이 27.071 이고 p 값이 유의수준 0.05 에서 매우 작으므로 유의하다. 마찬가지로 동기(\(x_2\))도 F 값이 11.020 이고 p 값이 유의수준 0.05 에서 매우 작으므로 유의하다. 그러므로 귀무가설 \(H_{01}\) : \(\beta_1 = 0\quad\text{OR}\quad\beta_2=0\) 을 기각한다.
모수 추정치 결과
summary(model2)
| Estimate | Std. Error | t | p | |
|---|---|---|---|---|
| Intercept | 18.827 | 5.123 | 3.675 | 0.0005 |
| \(x1\) (지능) | 0.277 | 0.053 | 5.203 | < 0.0001 |
| \(x2\) (동기) | 1.054 | 0.318 | 3.320 | 0.0016 |
| Method 2 수준별 |
-1.722 | 0.590 | -2.919 | 0.0051 |
| Method 3 전통별 |
-1.598 | 0.593 | -2.695 | 0.0093 |
동기를 제어한 후 지능의 효과를 보면 지능이 한단위 높아짐에 따라 성취가 0.277 만큼 증가하고 지능을 제어한 후 동기가 한단위 증가할 수록 성취도 1.054 만큼 증가한다. 이는 유의수준 0.05 에서 각각 p 값이 < 0.001 , 0.0016 으로 유의하다.
잔차 등분산성 검정
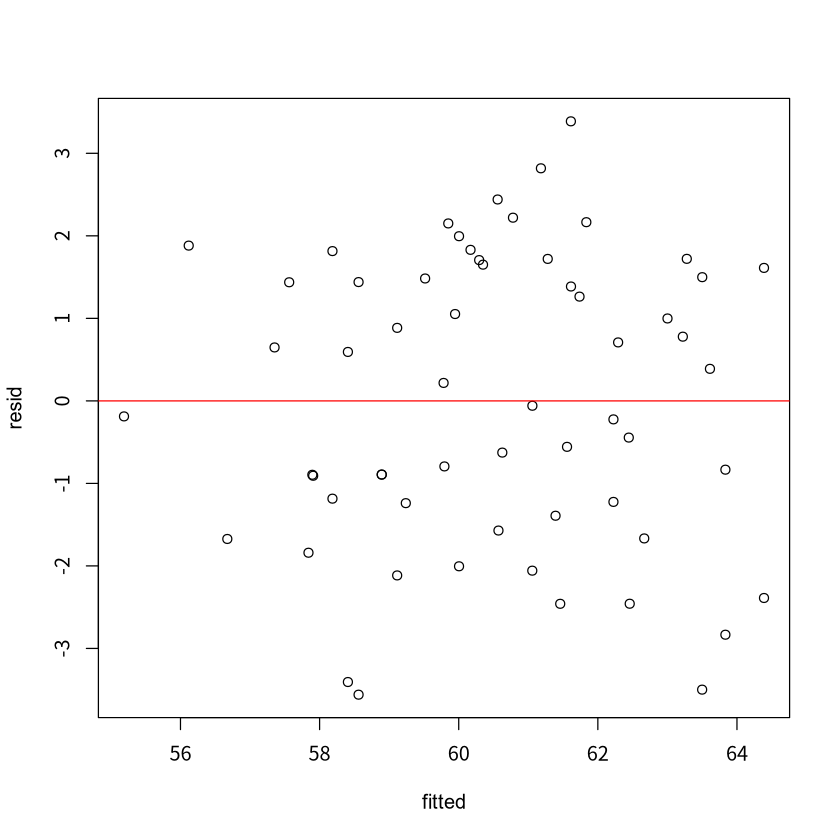
잔차에 대한 등분산 검정을 시행한 결과 p 값이 0.4005 이므로 유의수준 0.05 에서 등분산성을 만족한다.
잔차 정규성 검정
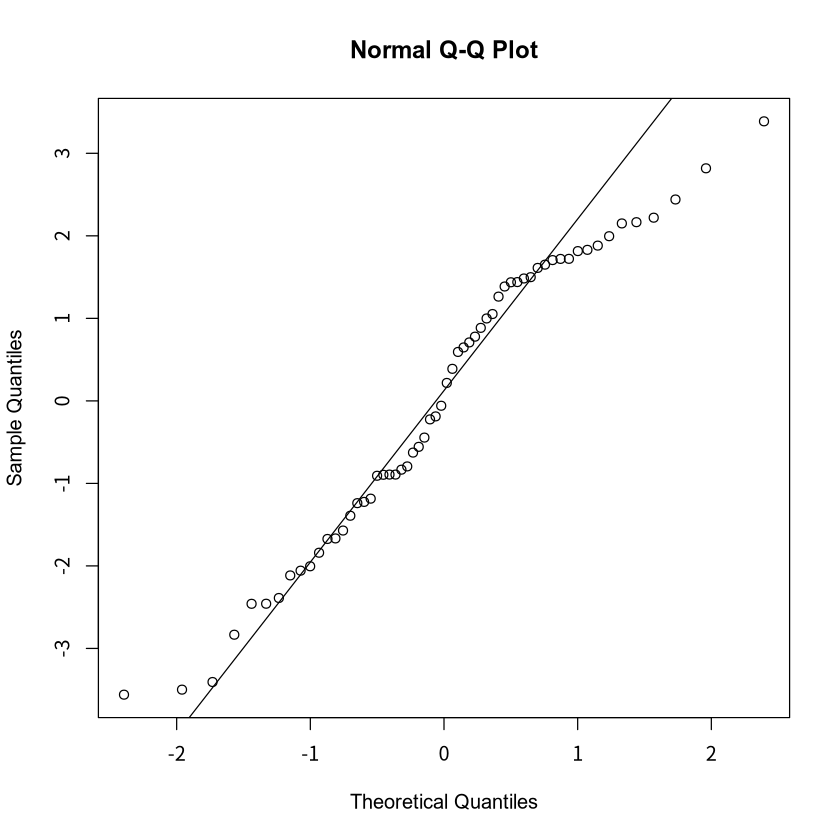
잔차에 대한 정규성 검정을 시행한 결과 p 값이 0.049 이므로 유의수준 0.05 에서 정규성을 만족하지 않지만 Q-Q plot 결과를 보았을때 소수의 이상치를 제외한 나머지 잔차는 Q-Q plot 의 직선에 가까워서 정규성을 따른다고 볼 수 있다.
보정 평균
구한 각 교육방법의 회귀식에서 공변량의 전체 평균값을 넣어 교육방법 별 보정된 평균을 위와 같이 계산하였다.
사후검정 (Tukey)
| Contrast | Estimate | SE | df | t Ratio | p |
|---|---|---|---|---|---|
| 혼합형 - 수준별 | 1.722 | 0.590 | 55 | 2.919 | 0.0138 |
| 혼합형 - 전통적 | 1.598 | 0.593 | 55 | 2.695 | 0.0249 |
| 수준별 - 전통적 | -0.124 | 0.585 | 55 | -0.212 | 0.9755 |
유의수준 0.05 하에서 수준별-전통적 p 값이 0.9755 이므로 수업 방법에 따라 성취의 평균에 차이가 있고 나머지 경우는 각각 0.0138, 0.0249 의 p 값을 가지므로 수업 방법에 따라 성취의 평균에 차이가 없다.