통계분석
분기
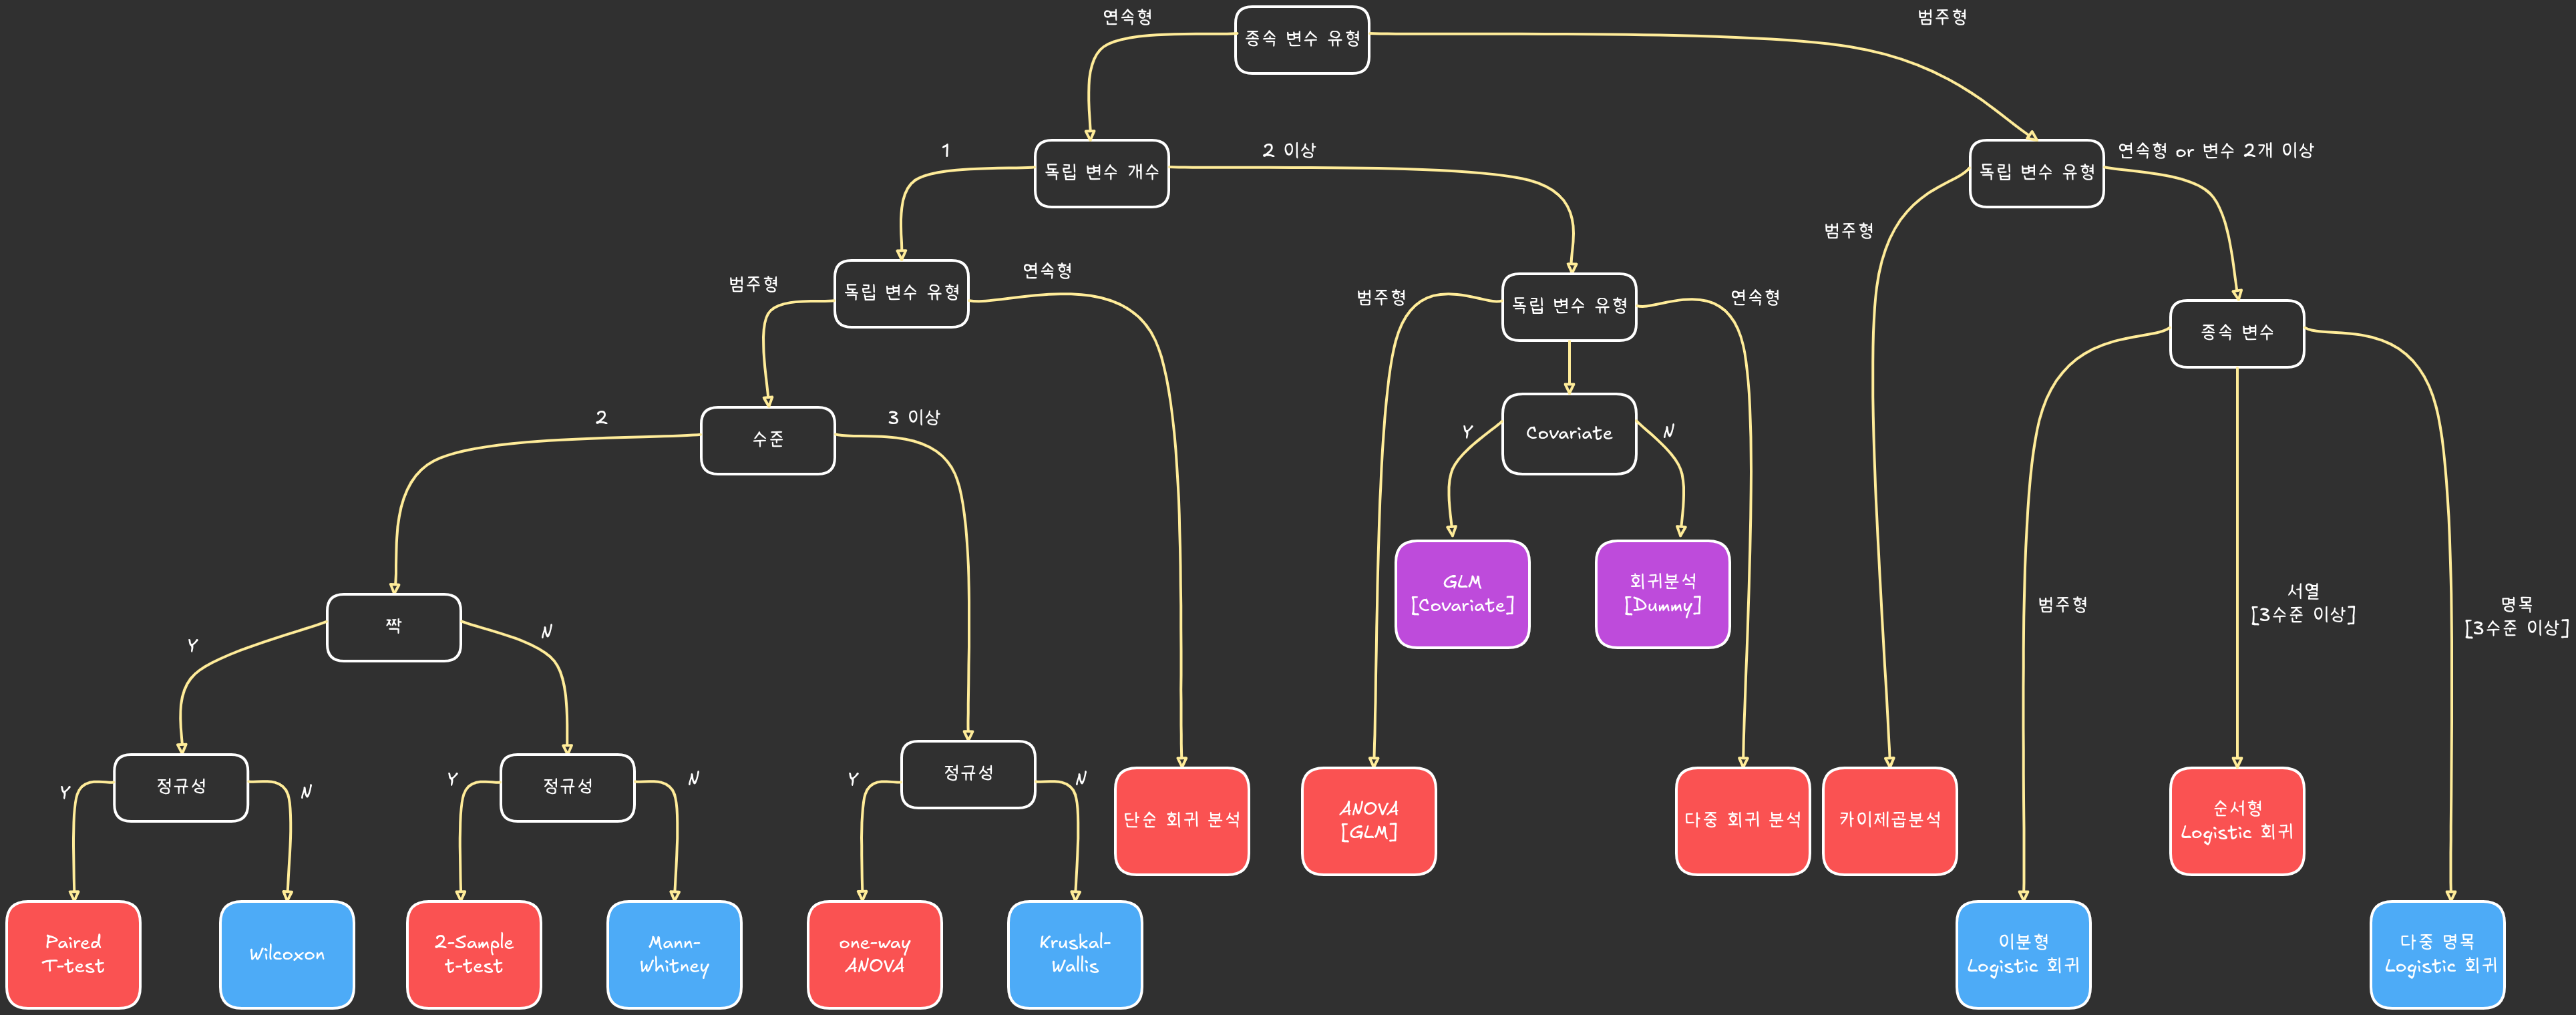
개념
OLS
Ordinary Least Squares, 일반 최소 제곱법 - 선형 회귀 모델에서 알려지지 않은 매개변수를 추정하는 방법 - 잔차 : 실제 관측값 - 회귀선 사이의 차이 - 잔차 제곱합 (RSS) - 실제 데이터와 예측값의 차이를 가장 작게 만드는 회귀 계수(모수) 모색
가정
- 종속 변수 - 독립변수 간 선형관계
| 방법 | 분류 |
|---|---|
| 단순회귀분석 | OLS |
| 다중 회귀 분석 | OLS |
| 회귀분석 (Dummy) | OLS |
| ANOVA (GLM) | OLS로 적합 가능 |
| GLM (covariate, ANCOVA) | OLS로 적합 가능 |
데이터 개요
변수 (선택됨)
Weight: 신생아 체중 Black: 흑인 어머니 여부 Married: 기혼 어머니 여부 Boy: 남자 아이 여부 MomAge: 어머니 나이 MomSmoke: 흡연 어머니 여부 CigsPerDay: 하루 흡연량 MomWtGain: 임신기간 어머니 체중 증가량 Visit: 산전 병원 방문 여부 MomEdLevel: 어머니 교육수준
수치형
- MomSmoke=1
| 구분 | Weight | CigsPerDay |
|---|---|---|
| mean | 3160.850605 | 11.301240 |
| std | 576.766602 | 7.399388 |
| min | 312.000000 | 1.000000 |
| max | 5245.000000 | 60.000000 |
| 50% | 3203.000000 | 10.000000 |
- MomSmoke=0
| 구분 | Weight | CigsPerDay |
|---|---|---|
| mean | 3402.305082 | 0 |
| std | 558.030705 | 0 |
| min | 240.000000 | 0 |
| max | 6350.000000 | 0 |
| 50% | 3430.000000 | 0 |
범주형
| Boy | MomSmoke |
|---|---|
| 0~1 | 0~1 |
개요
정규성
표본수가 충분히 크므로 정규성 가정
독립성
- 'MomSmoke' - "Boy" 의 독립 확보
-> chi2=0.159, dof=1, p=0.6901
ct = pd.crosstab(df["MomSmoke"], df["Boy"])
chi2, p_chi, dof, exp = chi2_contingency(ct, correction=False)
검정통계량, 자유도 , p-value
분산성
MomSmoke (True/False)
분산성
MomSmoke-Weight Levene 등분산 검정 (\(\alpha\) = 0.05) stat=5.361, p=0.0206 -> 이분산 가정 Levene 검정의 F-통계량, p-value
g0 = df.loc[df["MomSmoke"]==0, "Weight"].values
g1 = df.loc[df["MomSmoke"]==1, "Weight"].values

lev_stat, lev_p = levene(g0, g1, center='median')
equal_var = (lev_p >= 0.05)
print(" stat=%.3f, p=%.4g " % (lev_stat, lev_p))
t-test
- g0 : "MomSmoke" = 0 , n0 = 43467
- g1 : "MomSmoke" = 1 , n1 = 6533
- 평균 차 : -241.45
- 95% 신뢰구간 : [-256.39, -226.51]
Welch t-test 진행 (p=0.0206 < \(\alpha\)) -> 만약 아니었다면 Pooled t-test
n0, n1 = len(g0), len(g1)
m1, m0 = np.mean(g1), np.mean(g0)
s1, s0 = np.var(g1, ddof=1), np.var(g0, ddof=1)


# Welch t-test
se = np.sqrt(s1/n1 + s0/n0)
df_t = (s1/n1 + s0/n0)**2 / ((s1**2)/((n1**2)*(n1-1)) + (s0**2)/((n0**2)*(n0-1)))

ci_low = (m1-m0) - tdist.ppf(0.975, df_t)*se
ci_high = (m1-m0) + tdist.ppf(0.975, df_t)*se

print(f" t={t:.3f}, df={df_t:.1f}, p={p:.4g} ")
print(f" 평균차 = {(m1-m0):.2f}, 95% CI [{ci_low:.2f}, {ci_high:.2f}] ")
OLS (MomSmoke-Weight)
- 'MomSmoke' - "Boy" 의 독립성 확보 -> 모델에 추가(선택) 공변량 보정
가설
\(H_o\) : 어머니의 흡연 여부는 출생체중에 영향이 없다. -> \(\beta_{MomSmoke}\;=\;0\)
\(H_A\) : 영향이 있다. -> \(\beta_{MomSmoke}\;\neq\;0\)
\(H_o\) : 성별은 출생체중에 영향이 없다. -> \(\beta_{Boy}\;=\;0\)
\(H_A\) : 영향이 있다. -> \(\beta_{Boy}\;\neq\;0\)
분산성
Breusch–Pagan stat=37.275, p=8.049e-09 -> 이분산 존재 -> ols_modle(cov_type="HC1") 으로 신뢰구간 보고 -> n=50,000: HC1≈HC3. 차이는 미미하다.
m_status = smf.ols("Weight ~ C(MomSmoke) + Boy", data=df).fit()
bp_stat, bp_p, _, _ = het_breuschpagan(m_status.resid, m_status.model.exog)

print(" stat=%.3f, p=%.4g " % (bp_stat, bp_p))
m_status_rob = m_status.get_robustcov_results(cov_type="HC1")

print("\n OLS 결과 ")
print(m_status_rob.summary().tables[1])
결과
-> "HC3"
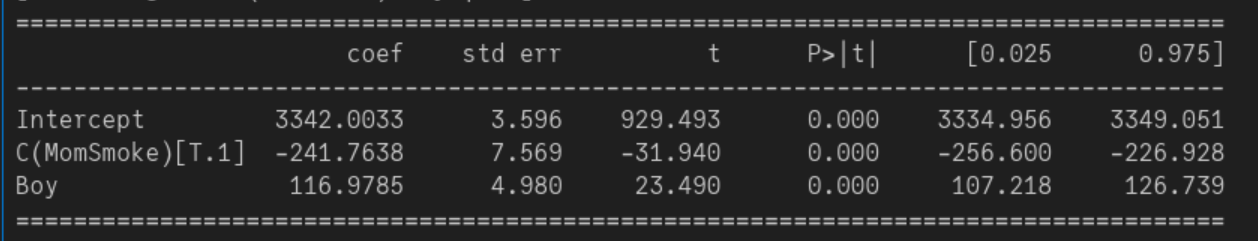
-> "HC1"
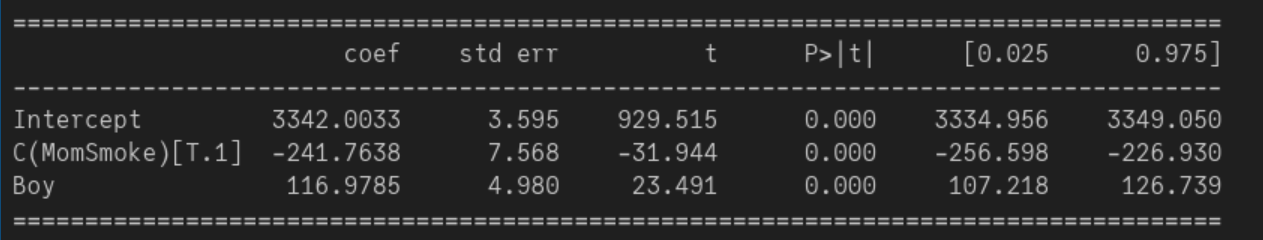 근거(OLS, 모형: Weight ~ C(MomSmoke)+Boy)
- C(MomSmoke) = −241.764
- SE=7.568
- t=−31.944
- p<0.001
- 95% CI [−256.598, −226.930]
- \(H_0\) 기각
예측 평균
- 비흡연·여아: 3342 g
- 흡연·여아: 3342 − 241.8 ≈ 3100 g
- 비흡연·남아: 3342 + 117.0 ≈ 3459 g
- 흡연·남아: 3459 − 241.8 ≈ 3217 g
결론 : 두 계수 모두 귀무가설 을 기각한다.
유의수준 0.05에서 어머니의 흡연여부에 따른 출생체중 평균은 통계적으로 유의하게 다르다.
-> 어머니가 흡연하면 출생체중이 평균 약 242g 낮다.
-> 남아는 여아보다 평균 약 117g 무겁다.
OLS (CigsPerDay-Weight)
- smk : "MomSmoke" = 1 , n1 = 6533 그룹 분석
- 'MomSmoke' - "Boy" 의 독립성 확보 -> 모델에 추가(선택) 공변량 보정
가설
\(H_o\) : 어머니의 흡연량은 출생체중에 영향이 없다. -> \(\beta_{CigsPerDay}\;=\;0\)
\(H_A\) : 영향이 있다. -> \(\beta_{CigsPerDay}\;\neq\;0\)
\(H_o\) : 성별은 출생체중에 영향이 없다. -> \(\beta_{Boy}\;=\;0\)
\(H_A\) : 영향이 있다. -> \(\beta_{Boy}\;\neq\;0\)
분산성
Breusch–Pagan : stat=2.584, p=0.2747 -> 이분산 없음 -> ols_modle(cov_type="HC1") 으로 신뢰구간 보고
m_dose = smf.ols("Weight ~ CigsPerDay + Boy", data=smk).fit()

bp2_stat, bp2_p, _, _ = het_breuschpagan(
    m_dose.resid, m_dose.model.exog
)
model
smk = df[df["MomSmoke"]==1].copy()
m_dose = smf.ols("Weight ~ CigsPerDay + Boy", data=smk).fit()
m_dose_rob = m_dose.get_robustcov_results(cov_type="HC1")

print("\n OLS 결과 ")
print(m_dose_rob.summary().tables[1])
결과
-> "HC3"
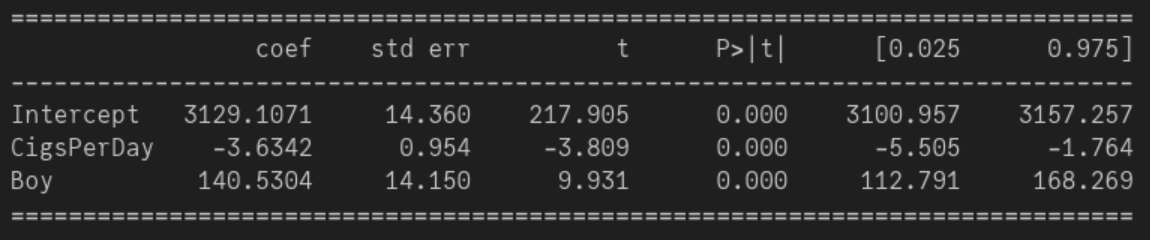
-> "HC1"
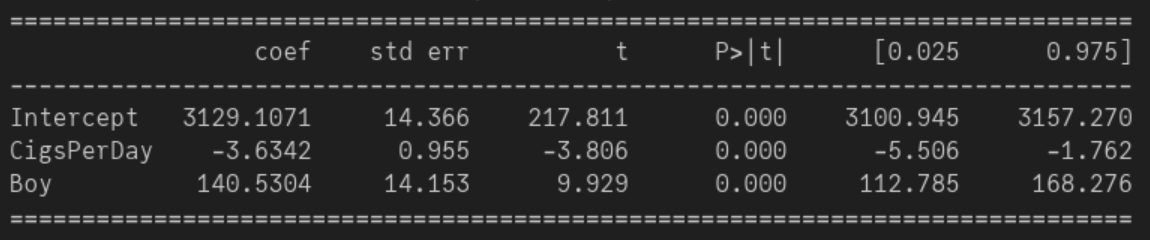 - 흡연량 (\(\hat \beta\)) = -3.6342
- SE = 0.954
- p < 0.001
- 95% CI [−5.505, −1.764]
결론 : 두 계수 모두 귀무가설을 기각한다. 양측검정에서 유의하다.
유의수준 0.05에서 흡연량은 출생체중 평균에 통계적으로 유의한 음의 영향을 미친다.
-> 개비 1개 증가시 평균 출생체중 약 3.63g 감소
추가
smk = df[df["MomSmoke"]==1].copy()

m_lin = smf.ols("Weight ~ CigsPerDay + Boy", data=smk).fit()
m_quad = smf.ols("Weight ~ CigsPerDay + I(CigsPerDay**2) + Boy", data=smk).fit()
print("\n 선형=%.1f, 제곱항=%.1f " % (m_lin.aic, m_quad.aic))
AIC
- 정의 : \(AIC\;=\;-2\mathbb l (\hat \theta)\;+\;2k\)
- \(\mathbb l\) : 최대로그우도, k : 추정된 모수 개수
- 목적 : 과적합 방지, 기대 예측오차에 가까운 모형 선택
- 비교조건 : 동일한 종속변수 , 동일한 관측치 세트에서 적합한 모형 비교
삼중비교 배제
- MomSmoke = 1 , CigsPerDay > 0 : 두 변수를 같은 모델에 넣으면 완전 공선성
- 상호작용 MomSmoke×CigsPerDay는 흡연자에서 CigsPerDay와 동일
- 설계행렬의 랭크가 떨어져 계수 식별 불가
완전 공선성
- 정의 : 설계행렬 열들 사이에 정확한 선형의존이 존재할 때
- 수식
- 결과 : \(XX'\) 가 비가역 -> OLS 해가 유일하지 않다. -> 열을 자동 제거하거나 계수 nan 처리됨
로버스트 SE
- stats(ols) 의 het_breuschpagan 함수 매개변수
- 정의 : 이분산·약한 모형 위반하에서도 유효한(consistent) 분산 추정이다. 회귀계수 \(\beta\) 는 그대로 두고, 표준오차·t값·신뢰구간만 바꾼다.
- 수식 :
- OLS 기본 \(\hat \Omega\;=\;\hat \sigma^2 I\)
- 로버스트 \(\hat \Omega\) = \(diag(u_i^2)\) 에 보정계수 (HC0~HC3) 를 곱한다.
- 사용:
- 이분산 의심 또는 진단 양성
- 독립성 위반 : 군집 의존, 시계열 자기상관 -> 전용 로버스트 필요
- 정규성 위반 시 대표본 근사에 기대고 싶을때
- 종류
- HC0 : 화이트(기본) , 표본 작으면 과소 추정 위험
- HC1 : HC0 에 \(\frac{n}{n-k}\) 보정 (스테이터 robust 유사)
- HC2 : 관측치 레버리지 \(h_{ii}\) 로 나눔
- HC3 : \((1-h_{ii})^2\) 으로 보정, 소-중간 표본, 고레버리지에 가장 보수적
- 주의 :
- 편항을 고치지 않는다. 모형 형태가 틀리면 계수 자체는 여전히 편향적
- AIC/BIC/로그우도 는 변하지않는다. 우도만 쓰므로 cov_type 과 무관
- 군집수가 적으면 클러스터 로버스트는 과소추정 가능
- 더 보수적인 변형 (CR2/CR3) 고려
코드
import pandas as pd
import numpy as np
import matplotlib as mpl
import seaborn as sns

import statsmodels.api as sm
import statsmodels.formula.api as smf
from scipy.stats import t as tdist
from scipy.stats import chi2_contingency, levene, ttest_ind, normaltest, kruskal, f_oneway, shapiro
from statsmodels.stats.anova import anova_lm
from statsmodels.stats.diagnostic import het_breuschpagan

df = pd.read_csv("bweight.csv")
need = ["Weight","MomSmoke","Boy","CigsPerDay"]
df = df[need].copy()
df = df.replace([np.inf,-np.inf], np.nan).dropna()
df = df[(df["Weight"]>0) & df["MomSmoke"].isin([0,1]) & df["Boy"].isin([0,1])]
df["CigsPerDay"] = df["CigsPerDay"].clip(lower=0)

ct = pd.crosstab(df["MomSmoke"], df["Boy"])
chi2, p_chi, dof, exp = chi2_contingency(ct, correction=False)
print(" chi2=%.3f, dof=%d, p=%.4g " % (chi2, dof, p_chi) )

g0 = df.loc[df["MomSmoke"]==0, "Weight"].values
g1 = df.loc[df["MomSmoke"]==1, "Weight"].values
n0, n1 = len(g0), len(g1)

lev_stat, lev_p = levene(g0, g1, center='median')
equal_var = (lev_p >= 0.05)
print(" stat=%.3f, p=%.4g " % (lev_stat, lev_p))

# 2표본 t-검정
t, p = ttest_ind(g1, g0, equal_var=equal_var)

# 평균차 및 95% CI
m1, m0 = np.mean(g1), np.mean(g0)
s1, s0 = np.var(g1, ddof=1), np.var(g0, ddof=1)

# Welch t-test
se = np.sqrt(s1/n1 + s0/n0)
df_t = (s1/n1 + s0/n0)**2 / ((s1**2)/((n1**2)*(n1-1)) + (s0**2)/((n0**2)*(n0-1)))

ci_low = (m1-m0) - tdist.ppf(0.975, df_t)*se
ci_high = (m1-m0) + tdist.ppf(0.975, df_t)*se

print(f" t={t:.3f}, df={df_t:.1f}, p={p:.4g} ")
print(f" 평균차 = {(m1-m0):.2f}, 95% CI [{ci_low:.2f}, {ci_high:.2f}] ")

# OLS (분산성 점검, 공변량 보정)
m_status = smf.ols("Weight ~ C(MomSmoke) + Boy", data=df).fit()
# bp_stat, bp_p, _, _ = het_breuschpagan(m_status.resid, m_status.model.exog)
m_status_rob = m_status.get_robustcov_results(cov_type="HC1")

print("\n OLS 결과")
print(m_status_rob.summary().tables[1])

smk = df[df["MomSmoke"]==1].copy()
m_dose = smf.ols("Weight ~ CigsPerDay + Boy", data=smk).fit()

# bp2_stat, bp2_p, _, _ = het_breuschpagan(m_dose.resid, m_dose.model.exog)

m_dose_rob = m_dose.get_robustcov_results(cov_type="HC1")

print("\n OLS 결과 ")
print(m_dose_rob.summary().tables[1])

# 선형 vs 비선형(제곱항) 비교
m_lin = smf.ols("Weight ~ CigsPerDay + Boy", data=smk).fit()
m_quad = smf.ols("Weight ~ CigsPerDay + I(CigsPerDay**2) + Boy", data=smk).fit()
print("\n 선형=%.1f, 제곱항=%.1f " % (m_lin.aic, m_quad.aic))