반복측정 자료분석
1
반복측정 자료분석을 하기 위해 만족되어야 하는 가정들을 서술하여라.
반복측정 자료분석에서 만족해야 할 핵심 가정은 오차항의 정규성, 구형성, 오차항의 동분산성, 그룹의 독립성이다. 이 중 구형성 가정은 반복측정 분산분석에서 가장 중요하며, Mauchly 검정으로 확인하고 위반 시 Greenhouse-Geisser 또는 Huynh-Feldt 수정을 적용한다.
2
아래 자료는 5명의 우울증 환자에게 새로운 치료법에 대해 1달 간격을 두고 우울증의 호전도를 점수로 매긴 것이다. 시간에 따라 우울증이 호전되었는지를 검정하고 그 결과를 해석하여라.
| 개체 | 1달 | 2달 | 3달 | 4달 |
|---|---|---|---|---|
| 1 | 30 | 28 | 16 | 34 |
| 2 | 14 | 18 | 10 | 22 |
| 3 | 24 | 20 | 18 | 30 |
| 4 | 38 | 34 | 20 | 44 |
| 5 | 26 | 28 | 14 | 30 |
연구 문제
- \(y_{jk}\) : j 번째 개체의 시점 k 에 측정한 반응 측정치
- \(\mu\) : 반응 측정치 \(y_{ijk}\) 의 전체 평균
- \(\gamma_k\) : 시점 k 의 효과
- \(\epsilon_{j} = (\epsilon_{j1} \cdots \epsilon_{jK})\) : 오차항
오차항은 평균이 0 인 독립적인 정규분포를 따른다고 가정한다.
가설 설정
\(H_0\) : 시간 간의 우울증 호전도의 차이가 없다. \(H_A\) : 시간 간의 우을증 호전도의 차이가 있다.
데이터 탐색
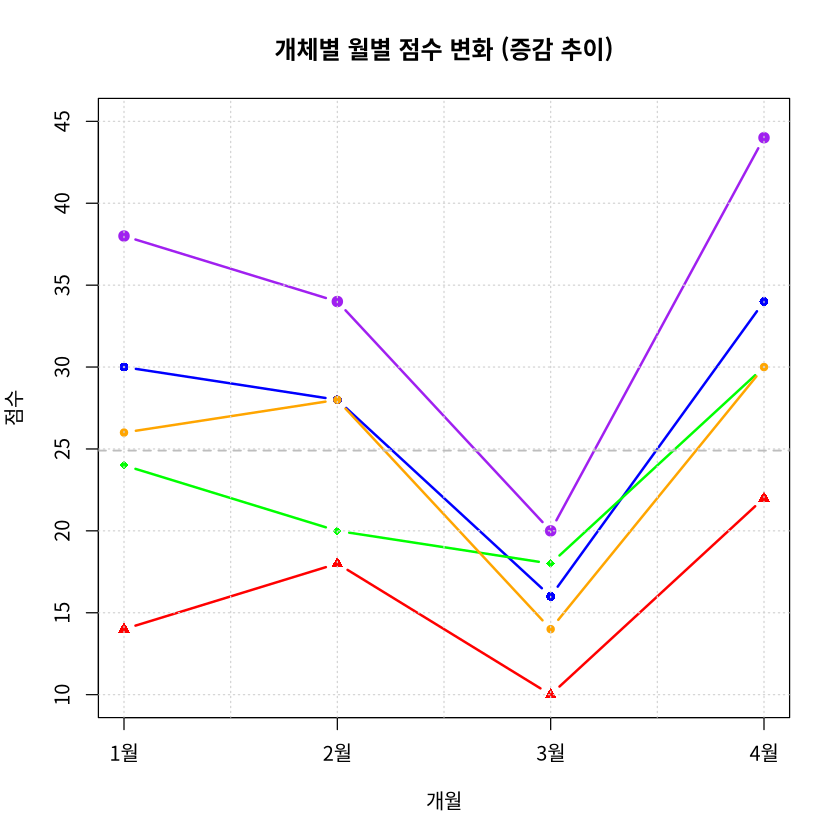
시간 간 차이의 변화
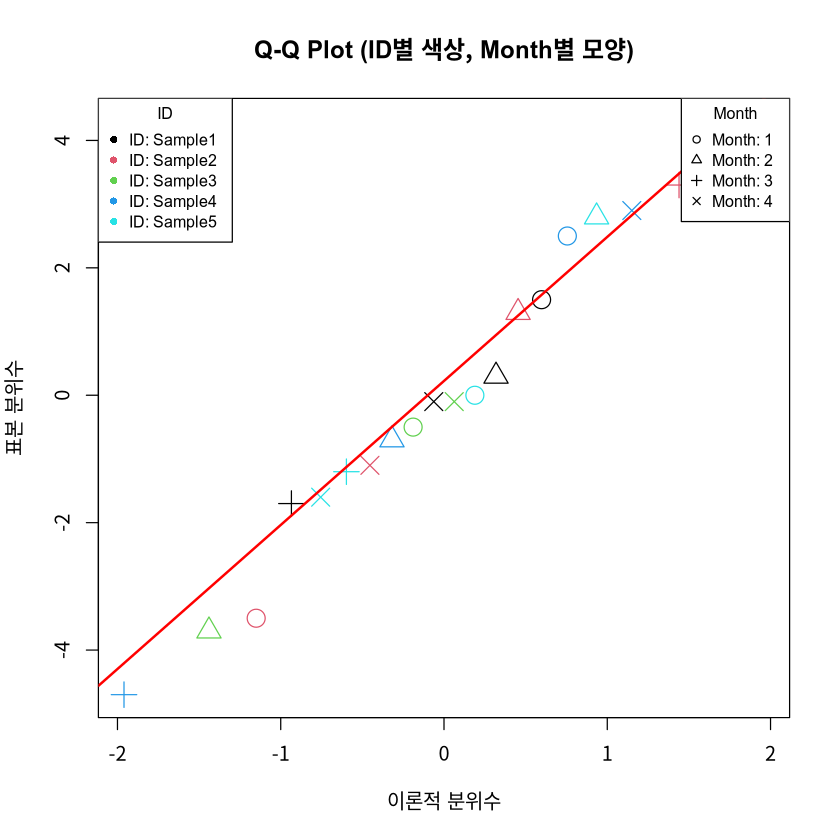
잔차의 정규성
분석 결과
잔차에 대해 정규성 검정을 Shapiro 검정을 통해 진행한 결과 \(W=0.9726\) , \(p-value = 0.8085\) 로 정규성을 만족하였으며
Mauchly's Test 결과 \(W = 0.1865\) , \(p-value = 0.4957\) 로 구형성 또한 만족하여 반복측정 분산분석 모형을 적용하였다.
| DF | SS | MS | F | P | |
|---|---|---|---|---|---|
| Month | 3 | 698.2 | 232.7 | 24.76 | < 0.001 |
| Residuals | 12 | 112.8 | 9.4 |
\(F=24.76\) , \(\color{#e36c09}p-value < 0.001\) 시간 간의 우울증 호전도 차이가 유의하게 나타났다.
사후검정 (Tukey)
시간 범주에 따라 각 차이의 유의성을 비교하기 위해 Tukey 사후 검정을 진행하였다.
| Month | Diff | Lower | Upper | p |
|---|---|---|---|---|
| 2-1 | -0.8 | -13.5436 | 11.9436 | 0.9979 |
| 3-1 | -10.8 | -23.5436 | 1.9436 | 0.1122 |
| 4-1 | 5.6 | -7.1436 | 18.3436 | 0.6015 |
| 3-2 | -10.0 | -22.7436 | 2.7436 | 0.1533 |
| 4-2 | 6.4 | -6.3436 | 19.1436 | 0.4959 |
| 4-3 | 16.4 | 3.6564 | 29.1436 | 0.0098 |
데이터 탐색에서 1달에서 3달까지는 감소하는 형태를 보였으나 3달과 4달사이 급격히 증가하는 형태를 보였는데, 사후 검정 결과에서도 마찬가지로 3달에서 4달간 16.4 점 증가했고 \(\color{#e36c09}p-value=0.0098\)로 통계적으로 유의미한 차이를 확인할 수 있었다.
부록
data_l <- data.frame(
  id = rep(1:5, each = 4),
  month = rep(c("month1", "month2", "month3", "month4"), times = 5),
  score = c(
    30, 28, 16, 34,
    14, 18, 10, 22,
    24, 20, 18, 30,
    38, 34, 20, 44,
    26, 28, 14, 30
  )
)

data_l$id <- factor(data_l$id,
                  levels = 1:5,
                  labels = c("Sample1", "Sample2", "Sample3", "Sample4", "Sample5"))

data_l$month <- factor(data_l$month,
                     levels = c("month1", "month2", "month3", "month4"),
                     labels = c("1", "2", "3", "4"),
                     ordered = TRUE)

data_l$score <- as.numeric(data_l$score)

data_w <- data.frame(
  id = 1:5,
  month1 = c(30, 14, 24, 38, 26),
  month2 = c(28, 18, 20, 34, 28),
  month3 = c(16, 10, 18, 20, 14),
  month4 = c(34, 22, 30, 44, 30)
)

data_w$id <- factor(data_w$id,
                    levels = 1:5,
                    labels = c("Sample1", "Sample2", "Sample3", "Sample4", "Sample5"))

out <- aov(score ~ month + id, data_l)
shapiro.test(resid(out))

qqPlot(out, main = "Q-Q Plot of Residuals")

leveneTest(resid(out), group = data_l$month)

plot(fitted(out), resid(out))
abline(h = 0, col = "red")


plot(1:4, data_l$score[1:4], type="b", col="blue", pch=16, lwd=2,
     xlab="개월", ylab="점수", main="개체별 월별 점수 변화 (증감 추이)",
     ylim=c(10, 45), xaxt="n")
axis(1, at=1:4, labels=c("1월", "2월", "3월", "4월"))

colors <- c("blue", "red", "green", "purple", "orange")
for(i in 2:5) {
  subset_idx <- (i-1)*4 + 1:4
  lines(1:4, data_l$score[subset_idx], type="b", col=colors[i], pch=15+i, lwd=2)
}

grid()
abline(h=mean(data_l$score), lty=2, col="gray", lwd=1.5)

model <- lm(cbind(month1, month2, month3, month4) ~ 1, data = data_w)
idata <- data.frame(time = factor(c("month1", "month2", "month3", "month4")))
mauchly_result <- mauchly.test(model, M = ~ time, X = ~ 1, idata = idata)
print(mauchly_result)

model <- aov(score ~ month + Error(id/month), data = data_l)
print(summary(model))

out <- aov(score ~ month, data = data_l)
print(TukeyHSD(out))
3
다음은 남,여 각각 5명씩 1달 간격으로 2가지의 운동방법 (A,B)을 적용하여 운동을 하게 한 후 10 분 간격으로 증가된 폐활량 지수를 측정한 자료이다.
| 개체/운동방법/성별 | 10분 | 20분 | 30분 | 40분 |
|---|---|---|---|---|
| 1AM | 21.3 | 21.1 | 22.6 | 24.2 |
| 2AM | 22.1 | 22.6 | 25.2 | 26.8 |
| 3AM | 21.6 | 25.2 | 25.7 | 28.2 |
| 4AM | 24.7 | 25.7 | 26.2 | 27.9 |
| 5AM | 22.6 | 24.1 | 23.8 | 24.5 |
| 1BM | 21.1 | 22.1 | 31.3 | 25.2 |
| 2BM | 22.6 | 26.2 | 30.5 | 26.2 |
| 3BM | 34.1 | 31.9 | 27.9 | 25.9 |
| 4BM | 28.2 | 35.6 | 26.5 | 30.2 |
| 5BM | 29.2 | 29.6 | 30.5 | 33.1 |
| 1AF | 27.3 | 20.1 | 20.1 | 24.1 |
| 2AF | 22.6 | 26.5 | 30.4 | 26.8 |
| 3AF | 24.2 | 23.6 | 24.2 | 27.2 |
| 4AF | 26.7 | 23.7 | 25.2 | 27.5 |
| 5AF | 22.3 | 28.2 | 28.1 | 24.7 |
| 1BF | 28.9 | 29.5 | 26.3 | 23.7 |
| 2BF | 29.2 | 28.5 | 25.9 | 26.2 |
| 3BF | 30.2 | 30.1 | 33.2 | 25.2 |
| 4BF | 27.6 | 26.5 | 31.0 | 22.6 |
| 5BF | 25.6 | 29.3 | 29.9 | 32.9 |
연구 문제
- \(y_{iljk}\) : 각 처리 i(성별), l(운동방법) 에서 j 번째 개체의 시점 k 에 측정한 반응 측정치
- \(\mu\) : 반응 측정치 \(y_{iljk}\) 의 전체 평균
- \(\alpha_{i}\) : 성별의 효과
- \(\nu_{i}\) : 운동방법의 효과
- \(\gamma_k\) : 시간 k 의 효과
- \(\beta_{ij}\) : 처리 i 내의 j 번째 개체 효과
- \(\beta_{lj}\) : 처리 l 내의 j 번째 개체 효과
- \(\alpha\nu_{il}\) : 성별 x 운동방법 교호작용
- \(\alpha\gamma_{ik}\) : 성별 x 시간 교호작용
- \(\nu\gamma_{lk}\) : 운동방법 x 시간 교호작용
- \(\alpha\nu\gamma_{ilk}\) : 성별 x 운동방법 x 시간 교호작용
- \(\epsilon_{ilj}\) : 오차항
(1) 성별에 따라 증가된 폐활량 지수에 차이가 있는가? (2) 운동 방법에 따라 증가된 폐활량 지수에 차이가 있는가? (3) 시간에 따라 증가된 폐활량 지수에 차이가 있는가? (4) 성별과 운동 방법 간에 교호작용이 존재하는가 (일변량 분석과 다변량 분석 결과를 비교하여라) (5) 성별과 시간간에 교호작용이 존재하는가? (6) 운동 방법과 시간에 교호작용이 존재하는가?
가설 설정
성별
\(H_{01}\) : 성별에 따라 증가된 폐활량 지수에 차이가 없다. \(H_{11}\) : 성별에 따라 증가된 폐활량 지수에 차이가 있다.
운동방법
\(H_{02}\) : 운동방법에 따라 증가된 폐활량 지수에 차이가 없다. \(H_{12}\) : 운동방법에 따라 증가된 폐활량 지수에 차이가 있다.
시간
\(H_{03}\) : 시간에 따라 증가된 폐활량 지수에 차이가 없다. \(H_{13}\) : 시간에 따라 증가된 폐활량 지수에 차이가 있다.
성별x운동방법
\(H_{04}\) : 성별과 운동방법간에 교호작용이 없다. \(H_{14}\) : 성별과 운동방법간에 교호작용이 있다.
성별x시간
\(H_{05}\) : 성별과 시간간에 교호작용이 없다. \(H_{15}\) : 성별과 시간간에 교호작용이 있다.
운동방법x시간
\(H_{06}\) : 운동방법과 시간에 교호작용이 없다. \(H_{16}\) : 운동방법과 시간에 교호작용이 있다.
데이터 탐색
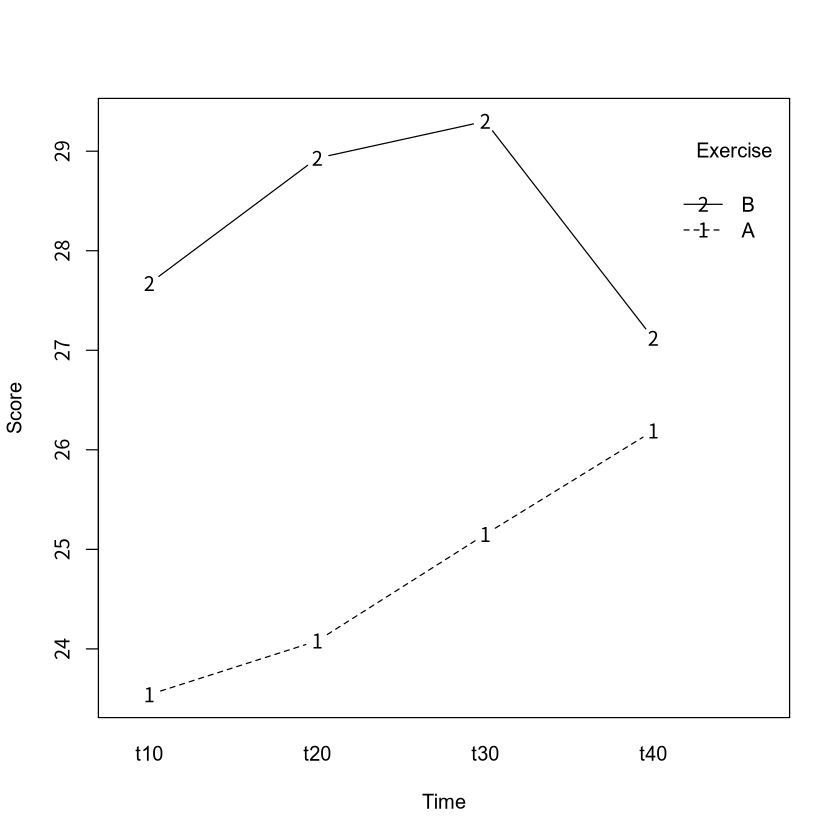
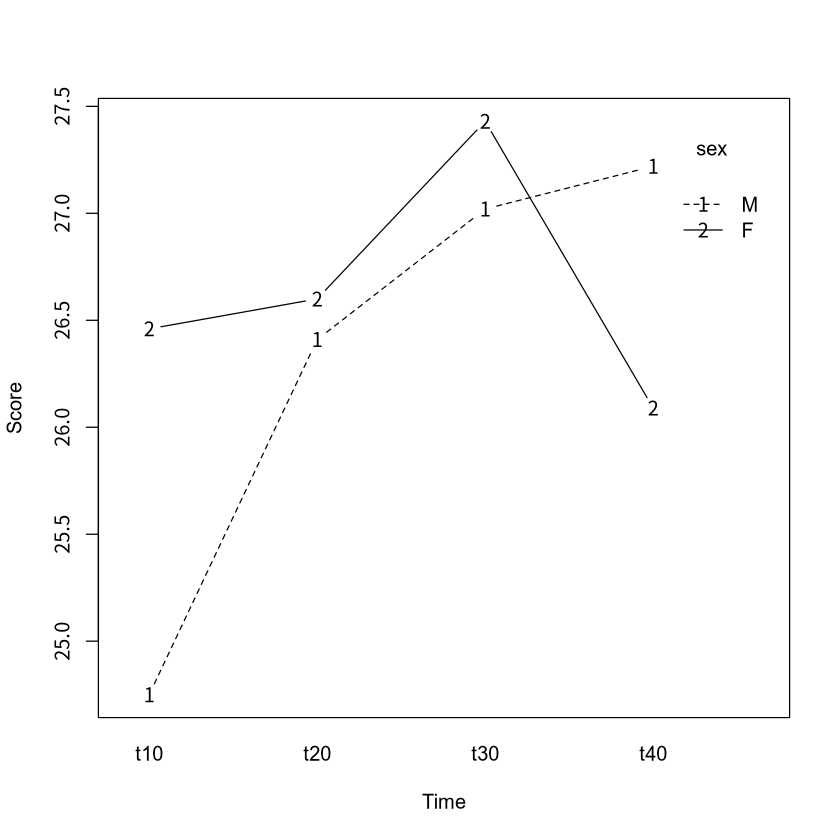
시간 간 차이의 변화
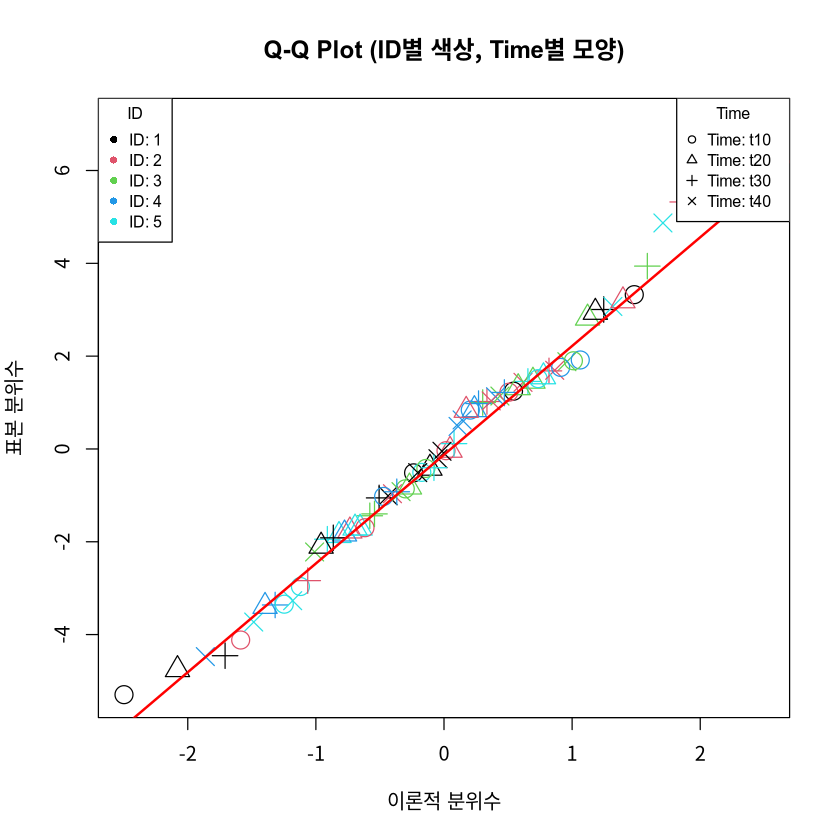
잔차의 정규성
분석 결과
잔차에 대해 정규성 검정을 Shapiro 검정을 통해 진행한 결과 \(W=0.98568\) , \(p-value = 0.515\) 로 정규성을 만족하였다.
Mauchly's Test 결과 \(W = 0.78253\) , \(p-value = 0.6075\) 로 구형성 또한 만족하여 반복측정 분산분석 모형을 적용하였다.
- Repeated Measure ANOVA Table
| SS | num Df | Error SS | den Df | F | P | |
|---|---|---|---|---|---|---|
| Intercept | 12675.6 | 1 | 199.62 | 16 | 1015.9692 | < 0.001 |
| Sex | 7.6 | 1 | 199.62 | 16 | 0.6067 | 0.4474 |
| Exercise | 86.4 | 1 | 199.62 | 16 | 6.9280 | 0.0182 |
| Time | 9.2 | 3 | 381.67 | 48 | 0.3861 | 0.7635 |
| Sex:Exercise | 6.6 | 1 | 199.62 | 16 | 0.5300 | 0.4771 |
| Sex:Time | 7.4 | 3 | 381.67 | 48 | 0.3121 | 0.8165 |
| Exercise:Time | 28.4 | 3 | 381.67 | 48 | 1.1923 | 0.3227 |
| Sex:Exercise:Time | 0.6 | 3 | 381.67 | 48 | 0.0245 | 0.9947 |
각 요인별 가설을 검정한 결과 성별에서는 \(F=0.6067\) , \(p-value=0.4474\) 로 폐활량 지수에 유의미한 차이가 없었고 운동방법에서는 \(F=6.9280\) , \(\color{#e36c09}p-value=0.0181\) 로 폐활량 지수에 유의미한 차이가 있었으며 시간에서는 \(F=0.3861\) , \(p-value=0.7635\) 로 폐활량 지수에 유의미한 차이가 없었다.
앞서 세운 교호작용의 가설을 검정한 결과 성별:운동방법에서는 \(F=0.53\) , \(p-value=0.4772\) 로 교호작용 항이 유의한 효과를 가지지 못했다. 성별:시간에서는 \(F=0.3121\) , \(p-value=0.8165\) 로 교호작용 항이 매우 유의한 효과를 가지지 못했다. 운동방법:시간에서는 \(F=1.1923\) , \(p-value=0.3227\) 교호작용 항이 유의한 효과를 가지지 못했다. 성별:운동방법:시간의 교호작용은 \(F=0.0245\) , \(p-value=0.9947\) 로 매우 유의하지 않은 결과를 얻을 수 있었다.
사후검정 (Tukey)
운동방법에 따라 각 차이의 유의성을 비교하기 위해 Tukey 사후 검정을 진행하였다.
| exercise | emmeans | SE | Df | Lower CI | Upper CI |
|---|---|---|---|---|---|
| A | 24.7 | 0.468 | 78 | 23.8 | 25.7 |
| B | 28.3 | 0.468 | 78 | 27.3 | 29.2 |
| contrast | estimate | SE | Df | t.ratio | P |
|---|---|---|---|---|---|
| A - B | -3.52 | 0.662 | 78 | -5.309 | < 0.001 |
운동방법 B 를 적용한 사람이 A을 적용한 사람보다 폐활량 지수가 3.52 높았다. 이는 \(\color{#e36c09}p-value < 0.001\) 로 통계적으로 매우 유의하였다.
결론
시간 및 성별에 따른 증가된 폐활량 지수에 통계적으로 유의미한 차이가 없었으며 연구 문제에서 제기한 모든 교호작용의 효과는 단변량 및 다변량 분석 에서 모두 통계적으로 유의하지 않았다. 오직 운동 방법에 따라 증가된 폐활량 지수에 차이가 있었다.
부록
data_l <- data.frame(
  id = rep(1:20, each = 4),
  sex = rep(c(rep("M", 10), rep("F", 10)), each = 4),
  exercise = rep(c(rep("A", 5), rep("B", 5), rep("A", 5), rep("B", 5)), each = 4),
  time = rep(c("t10", "t20", "t30", "t40"), times = 20),
  score = c(
    # 남-A (1~5)
    21.3, 21.1, 22.6, 24.2,
    22.1, 22.6, 25.2, 26.8,
    21.6, 25.2, 25.7, 28.2,
    24.7, 25.7, 26.2, 27.9,
    22.6, 24.1, 23.8, 24.5,
    # 남-B (1~5)
    21.1, 22.1, 31.3, 25.2,
    22.6, 26.2, 30.5, 26.2,
    34.1, 31.9, 27.9, 25.9,
    28.2, 35.6, 26.5, 30.2,
    29.2, 29.6, 30.5, 33.1,
    # 여-A (1~5)
    27.3, 20.1, 20.1, 24.1,
    22.6, 26.5, 30.4, 26.8,
    24.2, 23.6, 24.2, 27.2,
    26.7, 23.7, 25.2, 27.5,
    22.3, 28.2, 28.1, 24.7,
    # 여-B (1~5)
    28.9, 29.5, 26.3, 23.7,
    29.2, 28.5, 25.9, 26.2,
    30.2, 30.1, 33.2, 25.2,
    27.6, 26.5, 31.0, 22.6,
    25.6, 29.3, 29.9, 32.9
  )
)

data_l$sex <- factor(data_l$sex, levels = c("M","F"))
data_l$exercise <- factor(data_l$exercise, levels = c("A", "B"))
data_l$time <- factor(data_l$time, levels = c("t10", "t20", "t30", "t40"), ordered = TRUE)

data_w <- data.frame(
  id = 1:20,
  sex = c(rep("M", 10), rep("F", 10)),
  exercise = c(rep("A", 5), rep("B", 5), rep("A", 5), rep("B", 5)),
  t10 = c(21.3, 22.1, 21.6, 24.7, 22.6,
           21.1, 22.6, 34.1, 28.2, 29.2,
           27.3, 22.6, 24.2, 26.7, 22.3,
           28.9, 29.2, 30.2, 27.6, 25.6),
  t20 = c(21.1, 22.6, 25.2, 25.7, 24.1,
           22.1, 26.2, 31.9, 35.6, 29.6,
           20.1, 26.5, 23.6, 23.7, 28.2,
           29.5, 28.5, 30.1, 26.5, 29.3),
  t30 = c(22.6, 25.2, 25.7, 26.2, 23.8,
           31.3, 30.5, 27.9, 26.5, 30.5,
           20.1, 30.4, 24.2, 25.2, 28.1,
           26.3, 25.9, 33.2, 31.0, 29.9),
  t40 = c(24.2, 26.8, 28.2, 27.9, 24.5,
           25.2, 26.2, 25.9, 30.2, 33.1,
           24.1, 26.8, 27.2, 27.5, 24.7,
           23.7, 26.2, 25.2, 22.6, 32.9)
)

data_w$id <- factor(data_w$id)
data_w$sex <- factor(data_w$sex)
data_w$exercise <- factor(data_w$exercise)

model <- lm(score ~ sex + exercise + time +
              sex*exercise + sex*time + exercise*time +
              sex*exercise*time,
            data = data_l)

shapiro_result <- shapiro.test(resid(model))
leveneTest(resid(model), group = data_l$time)


model_manova <- lm(cbind(t10, t20, t30, t40) ~ sex * exercise,
                   data = data_w)

idata <- data.frame(time = factor(c("t10", "t20", "t30", "t40")))
idesign <- ~ time

mauchly_result <- mauchly.test(model_manova, X = ~ 1, idata = idata)
print(mauchly_result)

model_mlm <- lm(cbind(t10, t20, t30, t40) ~ sex + exercise + sex*exercise,
                  data = data_w)

idata <- data.frame(
  time = factor(c("t10", "t20", "t30", "t40"),
                levels = c("t10", "t20", "t30", "t40"))
)

rm_anova <- Anova(model_mlm,
                   idata = idata,
                   idesign = ~ time,
                   type = "III")

summary(rm_anova, multivariate = FALSE, univariate = TRUE)

summary(rm_anova, multivariate = TRUE)

model <- aov(score ~ exercise, data = data_l)
print(emmeans(model, pairwise ~ exercise, adjust="tukey"))
6
한 연구자는 간헐적 파행증 (intermittent claudication) 을 완화시키는 새로운 약인 노바플린 (Novafylline) 의 효과를 검정하고자 38명의 환자들을 랜덤하게 두 개의 그룹으로 나눈 후 첫 번째 그룹에게는 노바플린 약을 두번째 그룹에게는 위약을 1달 간격으로 5번 할당하고 러닝머신에서 걷게 하였다. 그런 다음 간헐적 파행증의 고통 때문에 걷기를 멈추기 까지의 거리를 측정하였다.
| 번호 | N0 | N1 | N2 | N3 | N4 | P0 | P1 | P2 | P3 | P4 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 190 | 212 | 213 | 195 | 248 | 187 | 177 | 200 | 190 | 206 |
| 2 | 98 | 137 | 185 | 215 | 225 | 205 | 230 | 172 | 196 | 232 |
| 3 | 155 | 145 | 196 | 189 | 176 | 165 | 142 | 195 | 185 | 170 |
| 4 | 245 | 228 | 280 | 274 | 260 | 256 | 232 | 252 | 326 | 292 |
| 5 | 182 | 205 | 218 | 194 | 193 | 197 | 182 | 160 | 210 | 185 |
| 6 | 140 | 138 | 187 | 195 | 205 | 134 | 115 | 150 | 165 | 170 |
| 7 | 196 | 185 | 185 | 227 | 180 | 196 | 166 | 166 | 188 | 205 |
| 8 | 162 | 176 | 192 | 230 | 215 | 167 | 144 | 176 | 155 | 185 |
| 9 | 195 | 232 | 199 | 185 | 200 | 98 | 102 | 89 | 128 | 130 |
| 10 | 167 | 187 | 228 | 192 | 210 | 167 | 175 | 122 | 162 | 125 |
| 11 | 123 | 165 | 145 | 185 | 215 | 123 | 136 | 147 | 130 | 135 |
| 12 | 105 | 144 | 119 | 168 | 165 | 95 | 102 | 154 | 105 | 112 |
| 13 | 161 | 177 | 162 | 185 | 192 | 181 | 177 | 140 | 212 | 230 |
| 14 | 255 | 242 | 330 | 284 | 319 | 237 | 232 | 245 | 193 | 245 |
| 15 | 144 | 195 | 180 | 184 | 213 | 144 | 172 | 163 | 158 | 188 |
| 16 | 180 | 218 | 224 | 165 | 200 | 182 | 202 | 254 | 185 | 173 |
| 17 | 126 | 145 | 173 | 175 | 140 | 165 | 140 | 153 | 180 | 155 |
| 18 | 175 | 155 | 154 | 164 | 154 | 196 | 195 | 204 | 188 | 178 |
| 19 | 227 | 218 | 245 | 235 | 257 | 175 | 197 | 195 | 182 | 193 |
연구 문제
- \(y_{ijk}\) : 처리 i 에서 j 번째 개체의 시점 k 에 측정한 반응 측정치
- \(\mu\) : 반응 측정치 \(y_{ijk}\) 의 전체 평균
- \(\alpha_{i}\) : i 번째 처리의 효과
- \(\beta_{ij}\) : 처리 i 에서 j 번재 개체의 효과
- \(\gamma_k\) : 시첨 k 의 효과
- \(\delta_{ik}\) : 처리 i 와 시점 k 의 교호작용 효과
- \(\epsilon_{ij} = (\epsilon_{ij1} \cdots \epsilon_{ijK})\) : 오차항
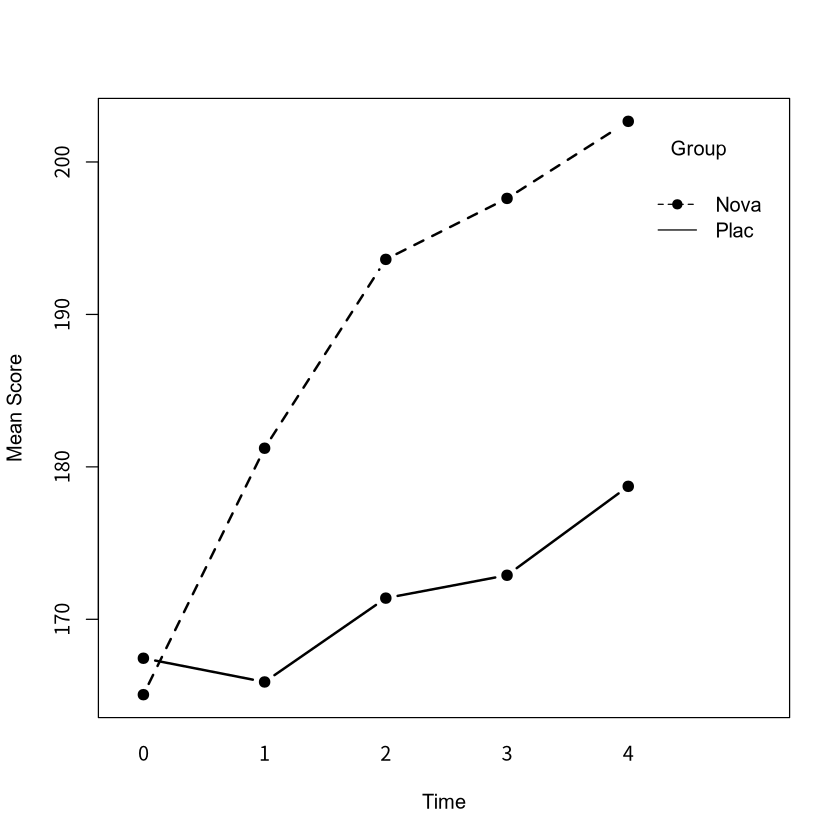
(1) 노바플린 약은 처리받은 집단과 위약을 처리받은 집단간에 운동 거리의 차이가 있는가? (2) 측정한 시간에 따라 운동 거리의 차이가 있는가? (3) 처리 받은 약과 측정한 시간 사이에 교호작용이 존재하는가? (일변량 분석과 다변량 분석 결과를 비교하여라)
가설 설정
데이터 탐색
시간 간 차이의 변화
잔차의 정규성
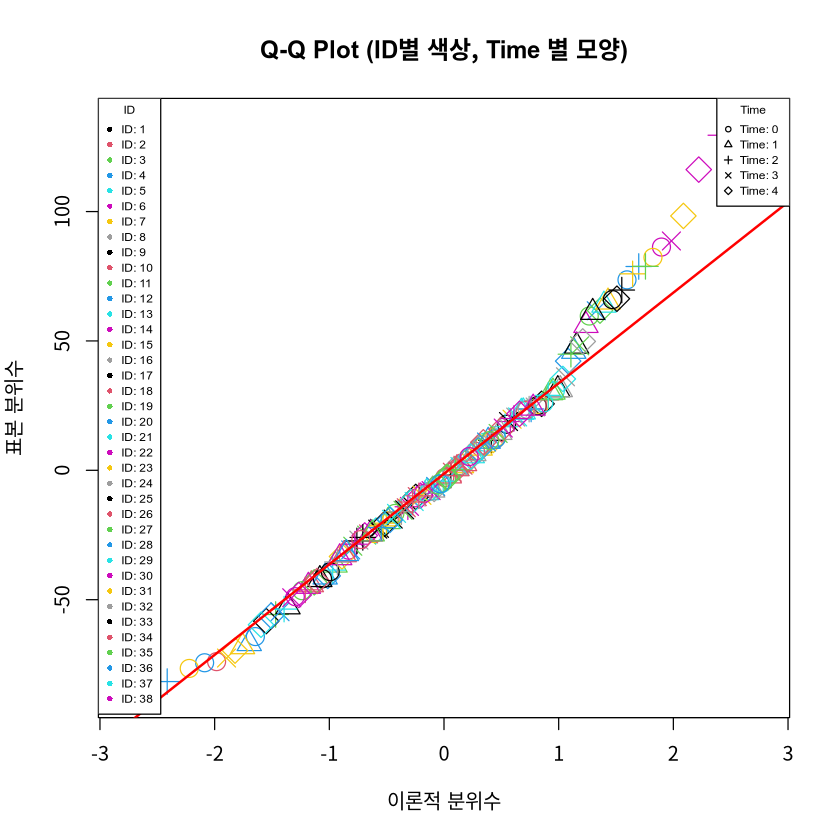
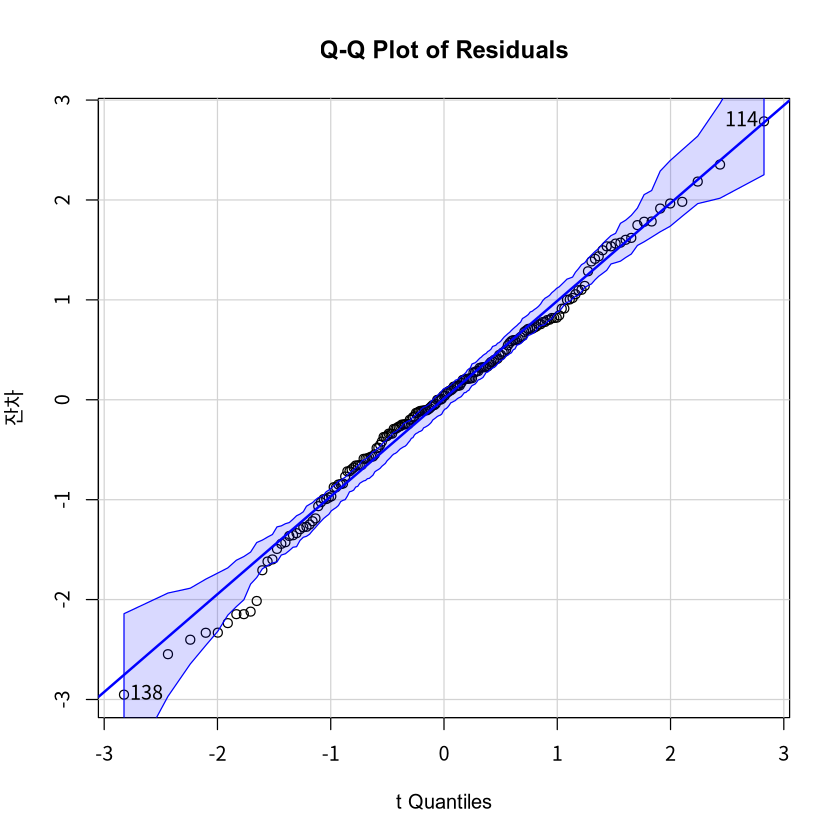
 전체 데이터에 대한 Q-Q Plot 결과 두개의 이상치가 발견되었고, Shapiro 검정 결과
\(W=0.9759\) , \(p-value=0.00228\) 로 정규성을 만족하지 않았다.
 첫째로 종속변수의 로그변환 Q-Q Plot 및 Shapiro 검정 결과
\(W=0.98979\) , \(p-value=0.1939\) 로 정규성을 만족하였다.
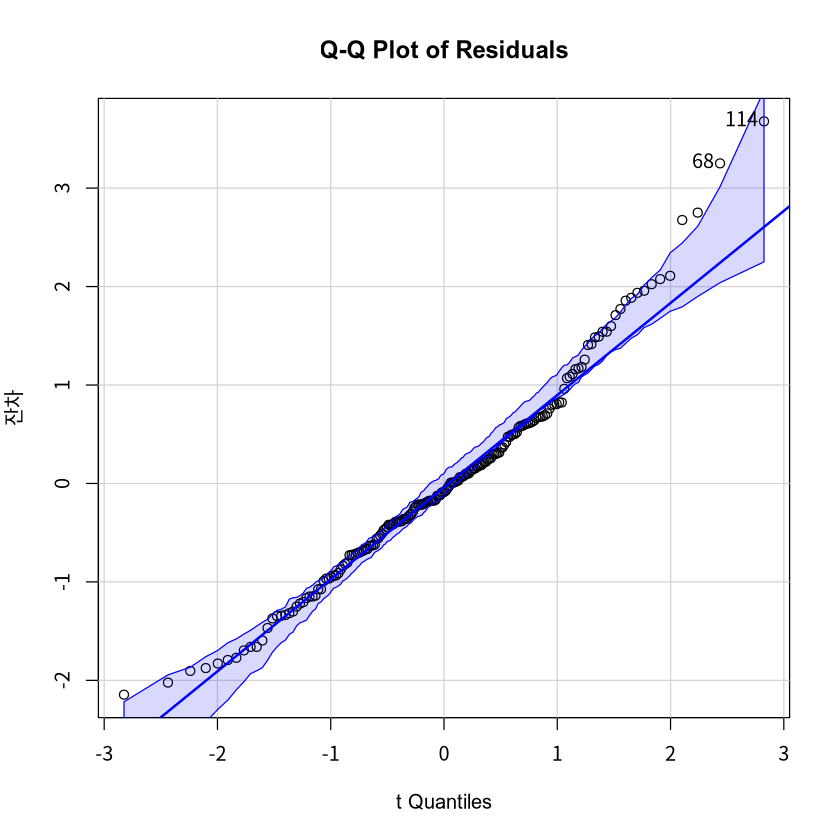
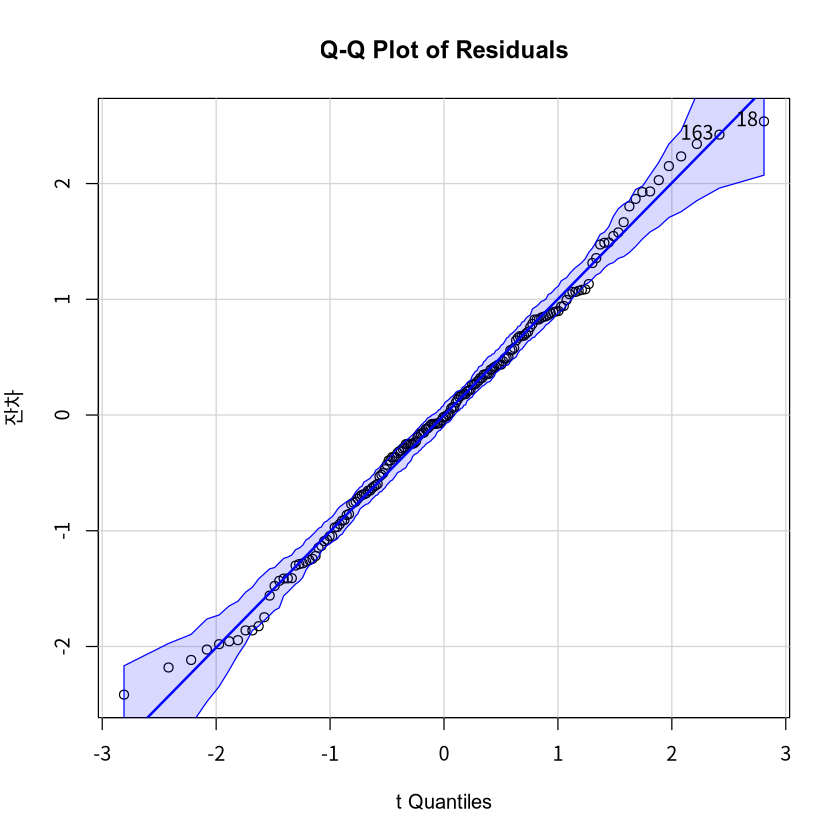 둘째로 이상치를 보이는 두명의 샘플 제외한 Q-Q plot 의 결과 샘플들의 잔차가 직선에 더 가깝게 위치하였고
Shapiro 검정결과 \(W=0.9930\) , \(p-value=0.5323\) 으로 정규성을 만족하였다.
이에 따라, 더욱 정규성을 만족하는 이상치를 제거한 표본을 채택하여 검정을 진행하기로 하였다.
분석 결과
Mauchly's Test 결과 \(W = 0.5594\) , \(p-value = 0.0269\) 로 구형성을 만족하지 않아 자유도를 보정한 결과와 다변량 분석결과를 살펴보기로 하였다.
단변량 분석
| SS | Df | Error SS | Df | F | P | |
|---|---|---|---|---|---|---|
| Intercept | 3182088 | 1 | 156095 | 34 | 693.1104 | < 0.001 |
| group | 12650 | 1 | 156095 | 34 | 2.7555 | 0.1061 |
| time | 16404 | 4 | 59184 | 136 | 9.4240 | < 0.001 |
| group:time | 4622 | 4 | 59184 | 136 | 2.6533 | 0.0357 |
- Greenhouse-Geisser
| GG eps | P | |
|---|---|---|
| time | 0.8182 | < 0.0001 |
| group:time | 0.8182 | 0.0471 |
- Huynh-Feldt
| HF eos | P | |
|---|---|---|
| time | 0.9157 | < 0.0001 |
| group:time | 0.9157 | 0.0405 |
그룹에서는 \(F=2.7555\) , \(p-value=0.1061\) 로 운동거리에 유의미한 차이가 없었고 시간에서는 \(F=9.4240\) , \(\color{#e36c09}p-value < 0.001\) 로 운동거리에 유의미한 차이가 있었다. 그룹:시간 교호작용 에서는 \(F=2.6533\) , \(\color{#e36c09}p-value = 0.0357\) 로 교호작용 항이 유의한 효과를 가졌다.
자유도가 보정된 결과에서도 각 시간과 그룹의 교호작용의 항은 모두 유의한 결과를 나타냈다.
다변량 분석
- group
| num Df | test stat | F | den DF | P | |
|---|---|---|---|---|---|
| Pillai | 1 | 0.0750 | 2.7555 | 34 | 0.1061 |
| Wilks | 1 | 0.9250 | 2.7555 | 34 | 0.1061 |
| Hotelling-Lawley | 1 | 0.0810 | 2.7555 | 34 | 0.1061 |
| Roy | 1 | 0.0810 | 2.7555 | 34 | 0.1061 |
- time
| num Df | test stat | F | den DF | P | |
|---|---|---|---|---|---|
| Pillai | 4 | 0.5299 | 8.7372 | 31 | < 0.001 |
| Wilks | 4 | 0.4701 | 8.7372 | 31 | < 0.001 |
| Hotelling-Lawley | 4 | 1.1274 | 8.7372 | 31 | < 0.001 |
| Roy | 4 | 1.1274 | 8.7372 | 31 | < 0.001 |
- group x time
| num Df | test stat | F | den DF | P | |
|---|---|---|---|---|---|
| Pillai | 4 | 0.3072 | 3.4361 | 31 | 0.0195 |
| Wilks | 4 | 0.6928 | 3.4361 | 31 | 0.0195 |
| Hotelling-Lawley | 4 | 0.4434 | 3.4361 | 31 | 0.0195 |
| Roy | 4 | 0.4434 | 3.4361 | 31 | 0.0195 |
그러나 앞서 구형성이 만족하지 않았으므로 다변량 분석을 진행하였다. 모든 검정방법에서 시간과 시간x그룹의 교호작용항은 각각 \(F=8.7372\) , \(\color{#e36c09}p-value<0.001\) \(F=3.4361\) , \(\color{#e36c09}p-value=0.0195\) 로 단변량 분석과 같은 결과를 얻었다.
사후검정 (Tukey)
투약 시점에 따라 각 차이의 유의성을 비교하기 위해 Tukey 사후 검정을 진행하였다.
| Contrast | Estimate | SE | Df | t.ratio | P |
|---|---|---|---|---|---|
| 0 - 1 | -17.44 | 17.1 | 170 | -1.021 | 0.8452 |
| 0 - 2 | -35.21 | 17.1 | 170 | -2.062 | 0.2416 |
| 0 - 3 | -45.33 | 17.1 | 170 | -2.655 | 0.0653 |
| 0 - 4 | -50.80 | 17.1 | 170 | -2.975 | 0.0274 |
| 1 - 2 | -17.77 | 17.1 | 170 | -1.040 | 0.8362 |
| 1 - 3 | -27.89 | 17.1 | 170 | -1.633 | 0.4783 |
| 1 - 4 | -33.36 | 17.1 | 170 | -1.954 | 0.2935 |
| 2 - 3 | -10.12 | 17.1 | 170 | -0.593 | 0.9760 |
| 2 - 4 | -15.59 | 17.1 | 170 | -0.913 | 0.8916 |
| 3 - 4 | -5.47 | 17.1 | 170 | -0.320 | 0.9977 |
투약 시작 과 3달 후의 차이는 45.33 이 증가하였으며 \(\color{#76923c}p-value=0.0653\) 으로 통계적으로 유의한 차이는 아니었다. 투약 시작 과 4달 후의 차이는 50.80 이 증가하였으며 \(\color{#e36c09}p-value=0.0274\) 로 통계적으로 유의함을 알 수 있었다.
결론
투약 여부에 따른 집단간 운동거리에 유의미한 차이는 존재하지 않았다. 하지만 시간간 운동거리에 유의미한 차이가 존재하였으며 지속적으로 증가하였고 4달 후에 통계적으로 유의미한 차이가 나타났다. 또한 투약 여부와 측정한 시간 사이에 교호작용은 유의미하게 존재했다. 이는 일변량 분석과 다변량 분석 모두에서 결론이 동일하였다.
부록
data_l <- data.frame(
  id = rep(1:36, each = 5),
  group = rep(c(rep("Nova", 18), rep("Plac", 18)), each = 5),
  time = rep(0:4, times = 36),
  score = c(
    # Novafolin 그룹 (19명 x 5회)
    190, 212, 213, 195, 248,  # id 1
    98, 137, 185, 215, 225,   # id 2
    155, 145, 196, 189, 176,  # id 3
    245, 228, 280, 274, 260,  # id 4
    182, 205, 218, 194, 193,  # id 5
    140, 138, 187, 195, 205,  # id 6
    196, 185, 185, 227, 180,  # id 7
    162, 176, 192, 230, 215,  # id 8
    195, 232, 199, 185, 200,  # id 9
    167, 187, 228, 192, 210,  # id 10
    123, 165, 145, 185, 215,  # id 11
    105, 144, 119, 168, 165,  # id 12
    161, 177, 162, 185, 192,  # id 13
    # 255, 242, 330, 284, 319,  # id 14
    144, 195, 180, 184, 213,  # id 15
    180, 218, 224, 165, 200,  # id 16
    126, 145, 173, 175, 140,  # id 17
    175, 155, 154, 164, 154,  # id 18
    227, 218, 245, 235, 257,  # id 19
    # Placebo 그룹 (19명 x 5회)
    187, 177, 200, 190, 206,  # id 20
    205, 230, 172, 196, 232,  # id 21
    165, 142, 195, 185, 170,  # id 22
    # 256, 232, 252, 326, 292,  # id 23
    197, 182, 160, 210, 185,  # id 24
    134, 115, 150, 165, 170,  # id 25
    196, 166, 166, 188, 205,  # id 26
    167, 144, 176, 155, 185,  # id 27
    98, 102, 89, 128, 130,    # id 28
    167, 175, 122, 162, 125,  # id 29
    123, 136, 147, 130, 135,  # id 30
    95, 102, 154, 105, 112,   # id 31
    181, 177, 140, 212, 230,  # id 32
    237, 232, 245, 193, 245,  # id 33
    144, 172, 163, 158, 188,  # id 34
    182, 202, 254, 185, 173,  # id 35
    165, 140, 153, 180, 155,  # id 36
    196, 195, 204, 188, 178,  # id 37
    175, 197, 195, 182, 193   # id 38
  )
)

data_l$time <- factor(
  data_l$time,
  levels = 0:4,
  labels = c("0", "1", "2", "3", "4")
)

data_l$group <- factor(
  data_l$group,
  levels = c("Nova", "Plac"),
  labels = c("Nova", "Plac")
)

data_l$score <- as.numeric(data_l$score)

data_w <- data.frame(
  id = 1:36,
  group = c(rep("Nova", 18), rep("Plac", 18)),
  t0 = c(190, 98, 155, 245, 182, 140, 196, 162, 195, 167, 123, 105, 161, 144, 180, 126, 175, 227,
            187, 205, 165, 197, 134, 196, 167, 98, 167, 123, 95, 181, 237, 144, 182, 165, 196, 175),
  t1 = c(212, 137, 145, 228, 205, 138, 185, 176, 232, 187, 165, 144, 177, 195, 218, 145, 155, 218,
            177, 230, 142, 182, 115, 166, 144, 102, 175, 136, 102, 177, 232, 172, 202, 140, 195, 197),
  t2 = c(213, 185, 196, 280, 218, 187, 185, 192, 199, 228, 145, 119, 162, 180, 224, 173, 154, 245,
            200, 172, 195, 160, 150, 166, 176, 89, 122, 147, 154, 140, 245, 163, 254, 153, 204, 195),
  t3 = c(195, 215, 189, 274, 194, 195, 227, 230, 185, 192, 185, 168, 185, 184, 165, 175, 164, 235,
            190, 196, 185, 210, 165, 188, 155, 128, 162, 130, 105, 212, 193, 158, 185, 180, 188, 182),
  t4 = c(248, 225, 176, 260, 193, 205, 180, 215, 200, 210, 215, 165, 192, 213, 200, 140, 154, 257,
            206, 232, 170, 185, 170, 205, 185, 130, 125, 135, 112, 230, 245, 188, 173, 155, 178, 193)
)

data_w$id <- factor(data_w$id)
data_w$group <- factor(data_w$group, levels = c("Nova", "Plac"))

out <- aov(score ~ time * group, data_l)
shapiro.test(resid(out))\
leveneTest(resid(out), group = data_l$group)

model <- lm(cbind(t0, t1, t2, t3, t4) ~ group, data = data_w)

idata = data.frame(time = factor(paste0("t", 0:4), levels = paste0("t", 0:4)))

mauchly_result <- mauchly.test(model, M = ~ time, X = ~ 1, idata = idata)

rm_anova <- Anova(
    model,
    idata = idata,
    idesign = ~ time,
    type = "III"
)

summary(rm_anova, multivariate = FALSE, univariate = TRUE)

summary(rm_anova, multivariate = TRUE)

Y <- as.matrix(data_w[, c("t0", "t1", "t2", "t3", "t4")])
within_factor <- factor(rep(0:4, 36))

manova_result <- manova(Y ~ data_w$group)
summary(manova_result)

model_rm <- lme(score ~ group * time, random = ~ 1 | id, data = data_l)
anova(model_rm)

model <- aov(score ~ time + Error(id/time), data=data_l)
print(emmeans(model, pairwise ~ time, adjust="tukey"))