Survival Analysis
개요
-
생존분석 (Survival Analysis) 사건이 발생가기 까지의 시간을 분석하는 통계기법
-
주요 관심
- 특정 시점까지 생존할 확률
- 1년 생존률, 5년 생존률, 환자 절반이 생존하는 시간(중앙생존시간)
- 두 그룹간 생존시간 분포 차이
- 생존에 영향을 미치는 요인 (나이, 성별, 기저질환)
- 특정 시점까지 생존할 확률
-
응용분야 : 의학 (사망,처리에 대한 반응, 질병의 재발), 공학 (부품수명) 등
생존시간 / 중도절단
- 생존시간 (T) : 사건 발생까지의 시간
- 중도절단 (Censoring) : 사건이 연구에서 이탈한 경우
- 제 1형 (고정 종료) : 연구 종료시점이 정해져 있음
- 제 2형 (고정 실패 수) : 사전에 관측할 사망자 수를 미리 정함
- 제 3형 (임의 절단) : 연구자가 통제 불가능한 이탈
모형
- \(T_i\) , \(C_i\) 는 서로 독립
함수
-
생존함수 \(S(t)\) : t 시간 이상 생존할 확률
- 추정 :
- 비모수정 : 분포 가정 없이 경험적으로 추정
- 모수정 : 특정 분포 (지수, Weibull) 가정
- 준 모수적방법 : Cox 비례위험모형
- 추정 :
-
생존시간 T 의 위험 함수 (Hazard) \(h(t)\) :
- t 시점까지는 생존했다가 t 시점 바로 직후 사망하게 되는 순간 위험률
비모수적 방법 개요
- 중도절단이 없는 경우
생존시간 \(x_1,x_2,\cdots,x_n\) 을 순서대로 배열 : \(t_1 < t_2 < \cdots < t_n\) 경험적 분포 함수 (Empirical Distribution Function) \(S(t_i)=P(T>t_i)\) : - 생존시간이 \(t_i\) 이상인 관측치 수 / 총 관측치 수 - 1 - (\(t_i\) 까지의 사망자 수) / n
- 중도절단이 있는 경우
- 생명표 방법 (Life-table) : 환자수가 상당히 많을 때 관측자료를 시간의 단위로 묶어 추정
- 누적 한계 추정법 (Product-Limit Method) : 환자 개개인의 관측 자료의 시점에서 추정, 생존곡선을 시각화 할 수 있다.
생명표 방법
- 개인별 측정이 불가능하다.
- 중도 절단이 있는 경우
- 구간별 요약 형태
- 유효 인원 수를 계산하는 것이 중요하다.
- 생존 시간을 k 개의 구간으로 나누어 계산
| 구간 | 사망자수 | 중도절단수 | 위험 그룹 인원수 | 유효인원수 | 사망률 | 생존율 | 생존함수 |
|---|---|---|---|---|---|---|---|
| \((t_{0}, t_1]\) | \(d_1\) | \(c_1\) | \(n_1\) | \(n'_1\) | \(\hat q_1\) | \(\hat p_1\) | \(\hat S(t_1)\) |
| \((t_{1}, t_2]\) | \(d_2\) | \(c_2\) | \(n_2\) | \(n'_2\) | \(\hat q_2\) | \(\hat p_2\) | \(\hat S(t_2)\) |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) |
| \((t_{i-1}, t_i]\) | \(d_i\) | \(c_i\) | \(n_i\) | \(n'_i\) | \(\hat q_i\) | \(\hat p_j\) | \(\hat S(t_i)\) |
| \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) | \(\vdots\) |
- \(n_i\) : i 번째 구간 시작 시점에서 생존사 수 \((n_i = n_{i-1} - d_{i-1} - c_{i-1})\)
- \(n_i'=n_i - {c_i \over 2}\)
- \(d_i\) : i 번쩨 구간에서 사망자 수
- \(c_i\) : i 번째 구간에서 중도 절단 인원 수
- \(p_i\) : i 번째 구간 내에서의 생존율 (\(q_i=1-p_i\))
- \(p_i=Pr(\text{i번째 구간에서 내내 생존}\;|\;\text{i번째 구간의 시작점에서 생존})=Pr(T>t_i\;|\;T>t_{i-1})\)
- \(S(t_i)\) = \(P(T>t_i)\)
- = \(P(T>t_i\;|\;T>t_{i-1})P(T>t_{i-1}\;|\;T>t_{i-2})\cdots P(T>t_1)\)
- \(p_ip_{i-1}\;\cdots\;p_2p_1\)
- Kaplan-meier (KM) 방법과 유사하다.
- \(\hat S(t_i)\;=\;\Pi_{k=1}^i(1- {d_k \over n_k'})\) 단, \(\hat S(0)=1\) : 생존 함수 추정치
- \(Var(\hat S(t_i))=\hat S^2(t_i)\sum_{k-1}^i {d_k \over n_k'(n_k' - d_k)}\) : 생존 함수 분산
예제
Data
| 진단 후 경과 기간 | 사망자 수 | 중도 절단 수 |
|---|---|---|
| (0 - 1] | 456 | 0 |
| (1 - 2] | 226 | 39 |
| (2 - 3] | 152 | 22 |
| (3 - 4] | 171 | 23 |
| (4 - 5] | 135 | 24 |
| (5 - 6] | 125 | 107 |
| (6 - 7] | 83 | 133 |
| (7 - 8] | 74 | 102 |
| (8 - 9] | 51 | 68 |
| (9 - 10] | 42 | 64 |
| (10 - 11] | 43 | 45 |
| (11 - 12] | 34 | 53 |
| (12 - 13] | 18 | 33 |
| (13 - 14] | 9 | 27 |
| (14 - 15] | 6 | 23 |
| (15 - ] | 0 | 30 |
| 1625 | 793 |
Result
| Interval | Number_Failed | Number_Censored | At_Risk | Effective_Sample_Size | Conditional_Prob_Failure | SE_Conditional_Prob | Survival_Start | Survival | SE_Survival | Failure_Start | Failure | SE_Failure | SE_PDF | Hazard | SE_Hazard | Median_Residual_Lifetime | SE_Median_Residual | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| [0, 1) | 456 | 0 | 2418 | 2418.0 | 0.188586 | 0.007955 | 1.000000 | 0.811414 | 0.007955 | 0.000000 | 0.188586 | 0.007955 | 0.188586 | 0.007955 | 0.208976 | 0.000197 | 4.8313 | 0.1757 |
| [1, 2) | 226 | 39 | 1962 | 1942.5 | 0.116345 | 0.007275 | 0.811414 | 0.717010 | 0.009139 | 0.188586 | 0.282990 | 0.009139 | 0.094404 | 0.012117 | 0.123688 | 0.000186 | 4.8313 | 0.1757 |
| [2, 3) | 152 | 22 | 1697 | 1686.0 | 0.090154 | 0.006975 | 0.717010 | 0.652369 | 0.009686 | 0.282990 | 0.347631 | 0.009686 | 0.064642 | 0.013317 | 0.094480 | 0.000186 | 4.8313 | 0.1757 |
| [3, 4) | 171 | 23 | 1523 | 1511.5 | 0.113133 | 0.008147 | 0.652369 | 0.578565 | 0.010079 | 0.347631 | 0.421435 | 0.010079 | 0.073804 | 0.013979 | 0.120060 | 0.000235 | 4.8313 | 0.1757 |
| [4, 5) | 135 | 24 | 1329 | 1317.0 | 0.102506 | 0.008358 | 0.578565 | 0.519259 | 0.010236 | 0.421435 | 0.480741 | 0.010236 | 0.059306 | 0.014365 | 0.108149 | 0.000256 | 4.8313 | 0.1757 |
| [5, 6) | 125 | 107 | 1170 | 1116.5 | 0.111957 | 0.009437 | 0.519259 | 0.461124 | 0.010216 | 0.480741 | 0.538876 | 0.010216 | 0.058135 | 0.014461 | 0.118735 | 0.000317 | 5.1656 | 0.1757 |
| [6, 7) | 83 | 133 | 938 | 871.5 | 0.095238 | 0.009943 | 0.461124 | 0.417207 | 0.010171 | 0.538876 | 0.582793 | 0.010171 | 0.043917 | 0.014416 | 0.100083 | 0.000371 | 5.5574 | 0.2316 |
| [7, 8) | 74 | 102 | 722 | 671.0 | 0.110283 | 0.012093 | 0.417207 | 0.371196 | 0.010182 | 0.582793 | 0.628804 | 0.010182 | 0.046011 | 0.014392 | 0.116852 | 0.000523 | 6.1003 | 0.2213 |
| [8, 9) | 51 | 68 | 546 | 512.0 | 0.099609 | 0.013235 | 0.371196 | 0.334222 | 0.010253 | 0.628804 | 0.665778 | 0.010253 | 0.036975 | 0.014450 | 0.104927 | 0.000648 | 6.2582 | 0.2773 |
| [9, 10) | 42 | 64 | 427 | 395.0 | 0.106329 | 0.015510 | 0.334222 | 0.298684 | 0.010332 | 0.665778 | 0.701316 | 0.010332 | 0.035538 | 0.014556 | 0.112418 | 0.000871 | 6.6676 | 0.2907 |
| [10, 11) | 43 | 45 | 321 | 298.5 | 0.144054 | 0.020324 | 0.298684 | 0.255658 | 0.010474 | 0.701316 | 0.744342 | 0.010474 | 0.043027 | 0.014713 | 0.155548 | 0.001366 | 7.6606 | 0.2434 |
| [11, 12) | 34 | 53 | 233 | 206.5 | 0.164649 | 0.025808 | 0.255658 | 0.213564 | 0.010488 | 0.744342 | 0.786436 | 0.010488 | 0.042094 | 0.014823 | 0.179903 | 0.002133 | 8.0976 | 0.2492 |
| [12, 13) | 18 | 33 | 146 | 129.5 | 0.138996 | 0.030400 | 0.213564 | 0.183879 | 0.010682 | 0.786436 | 0.816121 | 0.010682 | 0.029685 | 0.014970 | 0.149656 | 0.003085 | 7.1753 | 0.3599 |
| [13, 14) | 9 | 27 | 95 | 81.5 | 0.110429 | 0.034718 | 0.183879 | 0.163574 | 0.010944 | 0.816121 | 0.836426 | 0.010944 | 0.020306 | 0.015293 | 0.117016 | 0.004308 | 5.2160 | 0.5390 |
| [14, 15) | 6 | 23 | 59 | 47.5 | 0.126316 | 0.048201 | 0.163574 | 0.142912 | 0.011429 | 0.836426 | 0.857088 | 0.011429 | 0.020662 | 0.015824 | 0.135036 | 0.007969 | 5.8588 | 0.5531 |
| [15, 20) | 0 | 30 | 30 | 15.0 | 0.000000 | 0.000000 | 0.142912 | 0.142912 | 0.011429 | 0.857088 | 0.857088 | 0.011429 | 0.000000 | 0.003233 | 0.000000 | 0.000000 | NA | NA |
비모수적 방법 : 누적한계 추정법 (Kaplan-Meier)
생존함수 추정치
생존 함수 분산 (Greenwood)
특징
- 일치성, 근사적 정규성 만족, 표본 클 때 통계적 성질 우수
- 중도절단 시간에는 변하지 않고 사망이 관측된 시점에서 변화
- 사망과 중도 절단이 동시에 발생한 경우 사망이 중도 절단보다 먼저 관측된 것으로 봄
- 마지막 생존 시간이 중도 절단되 경우 그 이후 시간에 대한 추정치 정의하지 않음
예시
신장 이식 수술을 받은 15명 환자들의 호전기간 + 표시는 중도 절단된 자료를 나타냄
0 : 중도절단 1 : 사건발생
Data
| Id | 호전기간 (단위 : 일) |
|---|---|
| 1 | 3.0 |
| 2 | 4.0+ |
| 3 | 4.5 |
| 4 | 4.5 |
| 5 | 5.5 |
| 6 | 6.0 |
| 7 | 6.4 |
| 8 | 6.5 |
| 9 | 7.0 |
| 10 | 7.5 |
| 11 | 8.4 |
| 12 | 10.0 |
| 13 | 10.0+ |
| 14 | 12.0 |
| 15 | 15.0 |
Result
| 시간 | 위험군수 | 사건수 | 생존확률 | 표준오차 | X95.신뢰구간_하한 | X95.신뢰구간_상한 |
|---|---|---|---|---|---|---|
| 3.0 | 15 | 1 | 0.933333 | 0.064406 | 0.807097 | 1.000000 |
| 4.5 | 13 | 2 | 0.789744 | 0.108134 | 0.577801 | 1.000000 |
| 5.5 | 11 | 1 | 0.717949 | 0.119790 | 0.483161 | 0.952736 |
| 6.0 | 10 | 1 | 0.646154 | 0.127523 | 0.396208 | 0.896099 |
| 6.4 | 9 | 1 | 0.574359 | 0.132026 | 0.315588 | 0.833130 |
| 6.5 | 8 | 1 | 0.502564 | 0.133625 | 0.240658 | 0.764470 |
| 7.0 | 7 | 1 | 0.430769 | 0.132426 | 0.171214 | 0.690324 |
| 7.5 | 6 | 1 | 0.358974 | 0.128350 | 0.107409 | 0.610540 |
| 8.4 | 5 | 1 | 0.287179 | 0.121106 | 0.049811 | 0.524548 |
| 10.0 | 4 | 1 | 0.215385 | 0.110072 | 0.000000 | 0.431126 |
| 12.0 | 2 | 1 | 0.107692 | 0.093956 | 0.000000 | 0.291847 |
| 15.0 | 1 | 1 | 0.000000 | NaN | NaN | NaN |
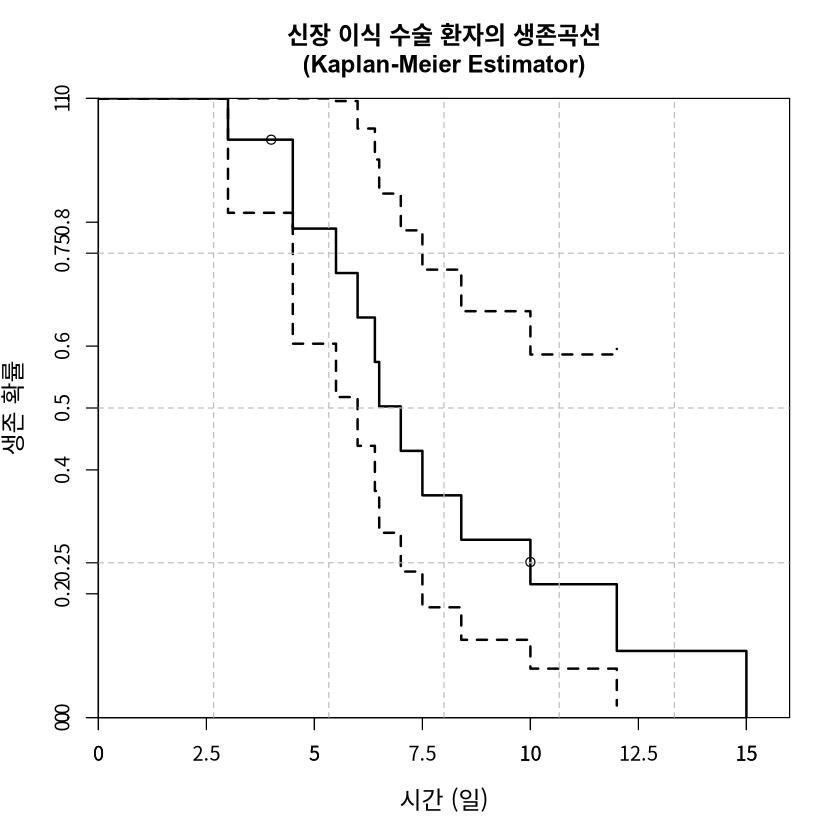
비모수적 방법을 이용한 생존 함수의 비교
중도 절단이 포함되어 있는 경우 두 그룹의 생존 분포 비교
첫번째 그룹 - 생존 시간 : \(T_{11}\), \(T_{12}\), \(\cdots\) , \(T_{1n_1}\) ~ \(S_1\) \(i.i.d\) - 중도 절단 시간 : \(C_{11}\), \(C_{12}\), \(\cdots\) , \(C_{1n_1}\) ~ \(G_1\) \(i.i.d\)
두번째 그룹 - 생존 시간 : \(T_{21}\), \(T_{22}\), \(\cdots\) , \(T_{2n_2}\) ~ \(S_2\) \(i.i.d\) - 중도 절단 시간 : \(C_{21}\), \(C_{22}\), \(\cdots\) , \(C_{2n_2}\) ~ \(G_2\) \(i.i.d\)
관측자료 (\(X_{ij}=min(T_{ij}, C_{ij}))\;,\;\delta_{ij}=I(T_{ij}<C_{ij}\)) - 첫번째 그룹 : (\(X_{11},\delta_{11}\)) , (\(X_{12},\delta_{12}\)) , \(\cdots\) , (\(X_{1n_1},\delta_{1n_1}\)) - 두번째 그룹 : (\(X_{21},\delta_{21}\)) , (\(X_{22},\delta_{22}\)) , \(\cdots\) , (\(X_{2n_2},\delta_{2n_2}\))
비모수적 방법을 이용한 생존 함수의 비교 : 특정시점 \(t_k\)
한계점 : - 특정시점 \(t_k\) 만 비교하므로 생존 곡선의 전체를 비교하기에 적합하지 않다. - 그룹간 차이가 어떤 시간대에 발생하는지 반영할 수 없다. - 대안으로 Log-rank 검정을 사용하게된다.
가설 - \(H_0\) : \(S_1(t_k)\) = \(S_2(t_K)\) - \(H_1\) : \(S_1(t_k)\) \(\neq\) \(S_2(t_K)\)
검정통계량
비모수적 방법을 이용한 생존함수의 비교 : 총괄적 비교 (Log-rank)
가설 - \(H_0\) : \(S_1\) = \(S_2\) - \(H_1\) : \(S_1\) \(\neq\) \(S_2\)
Mantel-Haenzel Log rank 검정법 \(t_1 < t_2 < \cdots < t_k\) : 두 그룹 자료를 섞어 순서대로 나열한 사망 시간 모든 \(t_i\) 에서 2차원 분할표 작성 ( 시점 : \(i\) )
| 사망 | 생존 | 계 | |
|---|---|---|---|
| 그룹 1 | \(d_{1i}\) | \(n_{1i}-d_{1i}\) | \(n_{1i}\) |
| 그룹 2 | \(d_{2i}\) | \(n_{2i}-d_{2i}\) | \(n_{2i}\) |
| 계 | \(d_{i}\) | \(n_{i}-d_{i}\) | \(n_{i}\) |
- \(n_{1i}, n_{2i}, d_i\) 가 고정되었다고 하면 귀무가설 하에서 \(d_{1i}\) 의 조건부 분포는 초기하분포
단측 검정을 하고자 할 때는 \(\sqrt{T} \sim Z\) 를 사용한다.
비모수적 방법을 이용한 생존함수의 비교 : 총괄적 비교 (Gehan)
- 가중 Log-rank 검정
- 위험집단이 크면 클 수록 , 초기시점 일 수록 가중치가 더 크게 부여된다.
- 초기 시점에서 그룹 간 차이에 더 민감하게 반응하는 검정 방법
- 각 시점에서 위험에 처해있는 인원수에 비례하는 가중치 \(w_i={n_i \over N_{+1}}\)
- 두 그룹의 위험률의 비가 상수 일때 로그 순위 검정법 선호
- 두 생존 함수가 서로 교차하는 경우에는 로그 순위 검정법은 부적합
준모수적(Semi) 방법을 이용한 생존 함수의 추정과 비교 : Cox Model
- 생존시간에 대한 분포 가정 없이 로그위험함수를 공변량의 선형함수로 모형화 하여 추정
- Cox regression 으로 불림
- 위험함수들 간에 비례관계만 명시할 뿐 완전한 확률모형이 아님
생존시간 \(T\) 에 영향을 주는 \(k\) 개의 공변량 \(x_1,x_2,\cdots,x_k\) 가 있을때, 위험함수 \(h_0(t)\) 는 기저위험함수 : 공변량의 값이 모두 0 일때 위험함수의 값
\(\alpha(t)\) 의 예 (모수적 모델) - 시간에 따라서 증가하거나 일정할 수 있다. - 지수분포 : \(\alpha(t)\) = \(\alpha_0\) - 곰페르츠분포 : \(\alpha(t)\) = \(\alpha_0\) + \(\alpha t\) - 와이블분포 : \(\alpha(t)\) = \(h_0+h\log t\)
- cox model 에서는 \(\alpha(t)\) 를 모수적으로 지정하지 않고 남겨둔다는 것이 장점이다.
비례 위험 모형
- i번째 j번째 환자의 위험함수의 비가 \(t\) 와 무관한 상수
- 함수 \(h\) 는 \(t\) 에 의존적이지만 결과는 \(t\) 에 의존적이지 않다.
비례위험 가정 확인 - 두 환자에 대해 시간에 따른 \(\log \hat h(t)\) 또는 \(\log(\log \hat S(t))\) 그래프가 평행인지 확인
Remarks - 완전한 우도함수를 유도할 수 없어서 회귀계수의 추정을 위해 편우도(Partial Likelihood) 이용 - 편우도 함수를 이용한 추정은 순위에만 의존하는 비모수적방법이지만, 완전한 우도함수에 비해 효율성이 크게 떨어지지 않음