집단의 비교
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import statsmodels.api as sm
import statsmodels.formula.api as smf
from statsmodels.formula.api import ols
from statsmodels.stats.anova import anova_lm
from scipy.stats import levene, shapiro, wilcoxon, f_oneway, probplot
3
다음 자료는 면역 4주전과 4주후의 Type III Group B Streptococcus (GBS) 에 대한 항체 농도이다. 면역 전후 간에 평균 항체 농도에 있어서 차이를 보이는지 5% 유의 수준으로 가설 검정하여라.
가설 설정
- \(H_o\) : 면역 전후 항체 농도 차이의 중앙값이 0 이다.
- \(H_A\) : 면역 전후 항체 농도 차이의 중앙값이 0 이 아니다.
과정
-
소표본에 유리한 shapiro 로 정규성을 점검했습니다.
- 검사 대상 : d = af -bf 의 정규성
- \(H_o\) : d 는 정규 분포를 따른다.
- \(H_A\) : d 는 정규 분포를 따르지 않는다.
- \(\alpha\;=\;0.05\)
- \(p-value\;=\;0.00025\)
- 귀무가설을 기각한다. \(\therefore\) 전후 차이 값의 정규성 위배 증거가 부족합니다.
-
종속변수 : Type III Group B Streptococcus (GBS) 항체 농도
- 독립변수 : 시점 ( 면역 4주전 | 면역 4주 후 ) [수준 : 2]
- 짝 지어진 독립 변수
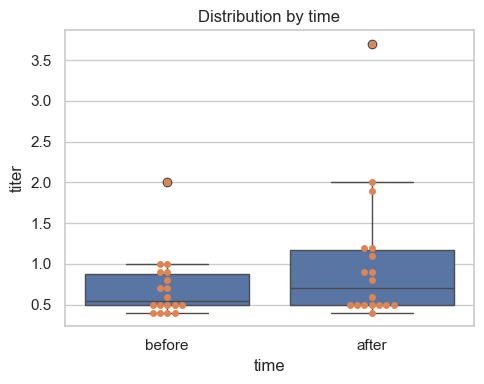
또한 변수들의 정의와 관계를 고려하고, 이상치 점검을 통해 Wilcoxon 검정 방법을 선택했습니다. 해석 대상은 중앙값 입니다.
n : 18
mean diff : 0.306
sd diff : 0.484
Wilcoxon : W=2.000, p=0.009
결론
정규성 기각 후 Wilcoxon 부호-서열 검정 결과 \(p = 0.009 < 0.05\) 로 귀무가설 기각 성공 면역 4주 후 GBS 항체 농도는 전보다 유의하게 증가했습니다.
코드
bf = np.array([0.4,0.4,0.4,0.4,0.5,0.5,0.5,0.5,0.5,0.6,0.7,0.7,0.8,0.9,0.9,1.0,1.0,2.0])
af =  np.array([0.4,0.5,0.5,0.9,0.5,0.5,0.5,0.5,0.5,0.6,1.1,1.2,0.8,1.2,1.9,0.9,2.0,3.7])

sh_stat, sh_p = shapiro(af - bf)
w_stat, w_p = wilcoxon(af, bf, zero_method='wilcox', alternative='two-sided', mode='auto')

print(f"n            : {len(af)}")
print(f"p            : {sh_p}")
print(f"mean diff    : {np.mean(af - bf):.3f}")
print(f"sd diff      : {np.std(af - bf, ddof=1):.3f}")
print(f"Shapiro W    : {sh_stat:.3f}, p={sh_p:.3f}")
print(f"Wilcoxon     : W={w_stat:.3f}, p={w_p:.3f}")
6
한 연구자는 특발성 폐섬유증 (idiopathic pulmonary fibrosis) 환자들을 대상으로 흡연이 폐기능 표준 점수에 어떠한 영향을 끼치는지 조사하기 위해 흡련 경력을 다음과 같이 '한번도 흡연을 하지 않은 사람' 과 '지금은 흡연을 하지 않으나 이전에 흡연을 한 사람' 그리고 '현재 흡연을 하는 사람' 으로 나누어서 폐기능 표준 점수를 측정하였다. 자료는 아래와 같다.
nos = [35.0, 120.0, 90.0, 109.0, 82.0, 40.0, 68.0, 84.0, 124.0, 77.0, 140.0]
bfs = [62.0, 73.0, 60.0, 77.0, 52.0, 115.0, 82.0, 52.0, 105.0, 143.0, 80.0]
crs = [96.0, 107.0, 63.0, 134.0, 140.0, 103.0, 158.0, 131.0, 76.0, 69.0, 69.0]

df = pd.DataFrame({
    "score": nos+bfs+crs,
    "group": ["NOS"]*11+["BFS"]*11+["CRS"]*11
})
가설 설정
- \(H_o\) : 비흡연자, 과거흡연자, 현재흡연자의 폐기능 표준 점수 평균이 같다(\(\mu_{nos}\;=\;\mu_{bfs}\;=\;\mu_{crs}\))
- \(H_A\) : 적어도 한 집단 평균이 다르다.
과정
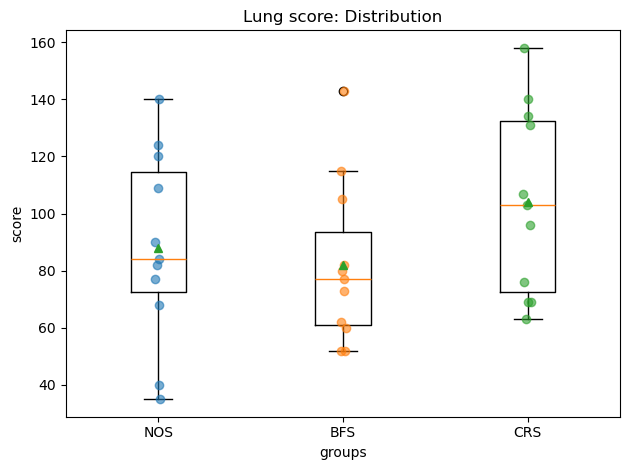 box plot 결과 이상치가 많이 존재하는 모습입니다.
| 요인 | 제곱합(SS) | 자유도(df) | 평균제곱(MS) | F |
|---|---|---|---|---|
| 집단간 | ssb | dfb | msb | msb/mse |
| 집단내 | sse | dfe | mse | |
| 전체 | sst | dft |
shapiro,Levene 로 집단별 정규성 및 등분산성을 점검했습니다.
집단별 정규성
- 검사 대상 : 각 집단에 대해
- \(H_o\) : 정규 분포를 따른다.
- \(H_A\) : 정규 분포를 따르지 않는다.
- \(\alpha\;=\;0.05\)
- \(p_{nos}\;=\;0.785\) , \(p_{bfs}\;=\;0.165\) , \(p_{crs}\;=\;0.360\)
- 모든 집단이 귀무 가설 기각에 실패했다.
- \(\therefore\) 모든 집단에 대해 정규성 위배 증거가 부족하다.
print("Shapiro :", {g: shapiro(df[df.group==g].score).pvalue for g in df.group.unique()})
집단간 등분산성
- 검사 대상 : 모든 집단
- \(H_o\) : 세 집단의 모분산은 동일하다. (\(\sigma^2_1=\sigma^2_2=\sigma^2_3\))
- \(H_A\) : 적어도 하나의 모분산이 다르다.
- 이상치가 많이 보이므로 Levene 검정을 선택했습니다.
- \(\alpha\;=\;0.05\)
- \(stat\;=\;0.317\;,\;p\;=\;0.730\)
- 귀무 가설 기각에 실패했다.
- \(\therefore\) 세 집단의 모분산은 등분산성 위배 증거가 부족하다.
stat_m, p_m = levene(nos, bfs, crs, center='mean')
변수
- 종속변수 : 폐기능 표준점수
- 독립변수 : 흡연 상태 ( 비흡연 | 과거흡연 | 현재흡연 ) [수준 : 3]
- 독립 표본
이므로 one-way ANOVA 검정 방법을 선택했습니다.
model = smf.ols("score ~ C(group)", data=df).fit()
aov = sm.stats.anova_lm(model, typ=2)
print(aov)
결론
유의수준 5%에서 귀무가설 기각 실패 세 집단의 평균 폐기능 표준점수 차이는 통계적으로 유의하지 않습니다. ANOVA 결과 \(F(2, 30)=1.449, p=0.251\)
                sum_sq    df         F    PR(>F)
C(group)   2908.424242   2.0  1.448541  0.250875
Residual  30117.454545  30.0       NaN       NaN
9
다음의 데이터는 남성 27명을 나이와 마리화나 사용여부에 따라 분류하여 감정적 성숙 점수를 측정한 결과이다.
| 나이/사용여부 | 사용안함 | 가끔 | 매일 |
|---|---|---|---|
| 15-19 | 25, 28, 22 | 18, 23, 19 | 17, 24, 19 |
| 20-24 | 28, 32, 30 | 16, 24, 20 | 18, 22, 10 |
| 25-29 | 25, 35, 30 | 14, 16, 16 | 10, 8, 12 |
data = {
"Age": ["15-19"]*9 + ["20-24"]*9 + ["25-29"]*9,
"Use": (["None"]*3 + ["Sometimes"]*3 + ["Daily"]*3)*3,
"Score": [
    25,28,22, 18,23,19, 17,24,19, # 15-19
    28,32,30, 16,24,20, 18,22,10, # 20-24
    25,35,30, 14,16,16, 10,8,12 # 25-29
    ]
}

df = pd.DataFrame(data)
- (1) 적절한 이원분산분석모형을 써라
- (2) 분산분석표를 작성하라
- (3) 적절한 가설을 세우고 유의수준 5% 내에서 검정하여라
데이터 시각화 분석
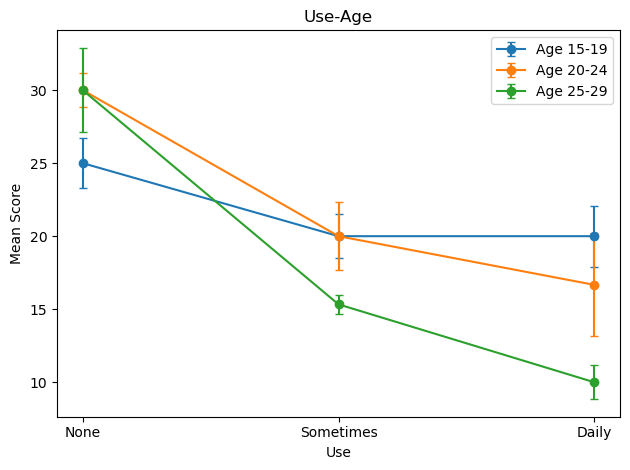 평행이 아니고 연령별 선이 교차 하거나 벌어져있음을 볼때 교호작용이 존재 함을 추측해볼 수 있습니다.
None 에서 연령 간 평균 차이가 다른 그룹보다 작습니다. 사용이 증가 할 수록 25~29 나이 그룹의 하락폭이 가장 크며 15~19 나이 그룹의 폭이 가장 완만합니다.
특히 Daily 그룹에서 15~19 나이 그룹이 20~24 나이그룹보다 높아졌으므로 나이 그룹에 따른 사용 효과가 분명히 존재함을 알 수 있습니다.
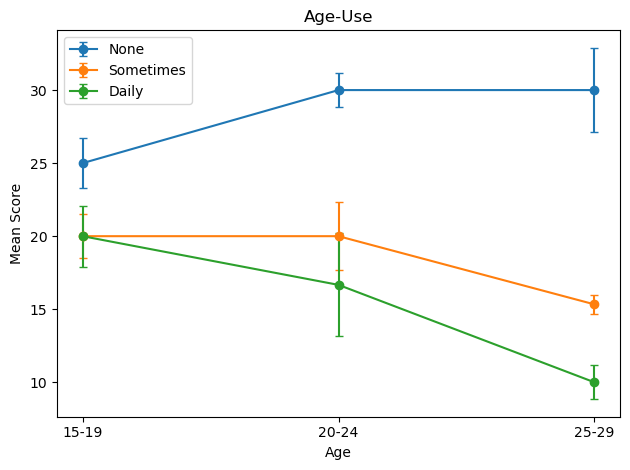 평행이 아니고 사용수준별로 기울기가 크게 다릅니다.
None: 나이가 들수록 증가하는 경향이나 25–29 그룹에서는 비슷합니다.
Sometimes: 25–29에서 상대적으로 급격한 감소를 보입니다.
Daily: 나이가 들수록 뚜렷한 감소를 보입니다.
이에, 나이효과는 사용수준에 따라 방향 및 크기가 달라지며 특히 Daily 그룹에서 연령 증가가 점수 감소와 강한 관계를 가짐을 알 수 있습니다. 또한 None 그룹에서는 연령간 오차막대의 겹침이 강하게 보이지만 Daily 에선 겹침이 작게 보이므로 연령차이가 강하게 나타남을 알 수 있습니다.
적절한 이원분산분석 모형
변수
- 종속변수 : 감정적 성숙 점수
- 독립변수 : 나이 [수준 : 3], 마리화나 사용 [수준 : 3]
- 독립 표본 : 3×3 각 셀 n=3, 셀 간 독립
모형
요인 \(\alpha\)=Age(3수준), 요인 \(\beta\)=Use(3수준), 각 조합에 원소 3
제약조건 :
- \(Y_{ijk}\) : 나이 i, 사용 j, 원소 k의 감정적 성숙 점수
- \(\mu\) : 전체 평균(총평균)
- \(α_i\) : 나이 수준 i의 주효과
- \(\beta_j\) : 사용 수준 j의 주효과
- \((αβ)_{ij}\) : 나이×사용 교호작용 효과
- \(\epsilon_{ijk}\) : 측정값의 랜덤 오차
- \(\sigma^2\) : 공통 오차분산
분산분석표
| 요인 | 제곱합(SS) | 자유도(df) | 평균제곱(MS) | F 통계량 |
|---|---|---|---|---|
| 나이(A) | 74.888889 | a-1=2 | MSA=SSA/2(72.4) | \(F_A\)=MSA/MSE(2.888) |
| 사용(B) | 808.222222 | b-1=2 | MSB=SSB/2(404.1) | \(F_B\)=MSB/MSE(31.174) |
| 교호작용 |
174.222222 | (a-1)(b-1)=4 | MSAB=SSAB/4(43.5) | \(F_{AB}\)=MSAB/MSE (3.360) |
| 오차 | 233.333333 | ab(n-1)=18 | MSE=SSE/18(12.96) | |
| 전체 | 1290.666666 | abn-1=26 |
ㅌ## 적절한 가설을 세우고 유의수준 5% 내에서 검정
가설
- 상호작용 \(H_o,{AGE*USE}\) : \(\alpha_{ai}\alpha_{uj}\)=0
- 나이 주효과 \(H_o,{AGE}\) : \(\alpha_{a1} = \alpha_{a2} = \alpha_{a3} = 0\)
- 사용 주효과 \(H_o,{USE}\) : \(\alpha_{u1} = \alpha_{u2} = \alpha_{u3} = 0\)
- \(H_A\) : 위 귀무가설 중 적어도 하나는 0 이 아니다. -> 각각의 귀무가설에 대립가설 다 써줄것
검정
위 모형을 바탕으로 이원 분산 분석 모델을 지정 후 분석했습니다.
ols_model = ols("Score ~ C(Age) * C(Use)", data=df).fit()
정규성
우선 이 모델의 잔차가 정규성을 따르는지 확인하기위해 shapiro 검사를 진행했습니다.
resid = ols_model.resid
shapiro_stat, shapiro_p = shapiro(resid)
print(f"Shapiro-Wilk p: {shapiro_p:.4f}")
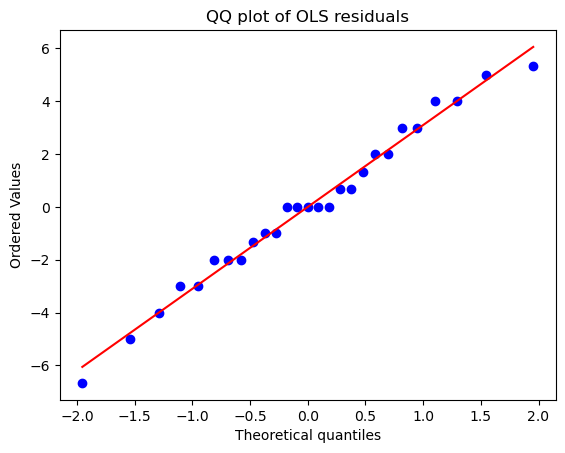
plt.figure()
sm.qqplot(resid, dist="norm" , fit=True)
plt.title("Q-Q plot of residuals")
plt.show()
결론
- 상호작용 \(H_{0,\;Age\times Use}\) 기각: \(F(4,18)=3.36,\;p=0.032<0.05\)
- 사용 주효과 \(H_{0,\;Use}\) 기각: \(F(2,18)=31.17,\;p<0.001\)
- 나이 주효과 \(H_{0,\;Age}\) 기각 실패: \(F(2,18)=2.89,\;p=0.082\ge 0.05\)
                   sum_sq    df          F    PR(>F)
C(Age)          74.888889   2.0   2.888571  0.081661
C(Use)         808.222222   2.0  31.174286  0.000001
C(Age):C(Use)  174.222222   4.0   3.360000  0.032034
Residual       233.333333  18.0        NaN       NaN
전반적으로 사용 빈도가 높을수록 점수가 낮습니다. 감소폭은 연령이 높을수록 커지며, 특히 25–29에서 하락이 가장 큽니다. 나이의 단독 효과는 유의수준 5% 내에서 ... -> 사후검정 해야함 (얼마나 차이가 나는지) -> 상호작용 , 사용 , 나이 에 대해 각각 결론내야함 -> 교호작용이 유의하지 않으면 빼라 그러면 결과가 바뀔 수 있다.
분할표분석
1,4,7 : 홍성진 님 그룹 2,5,8 : 박종일 님 그룹 3,6,9 : 조성준 님 그룹
파이널 프로젝트 : 12.10 (종강) - 발표, 10.29 (중간고사) - 필기 10.15 -> 분석할 데이터를 발표하는 시간