생존분석
1
중도 절단의 세 가지 형태를 간단히 비교하여 기술하여라
중도 절단이란 사건이 연구에서 여러 이유로 이탈한 경우를 의미하며 세가지 형태로 구분된다. 제 1 형태는 연구자에 의해 중도 절단 시간이 고정되는것 제 2 형태는 사전에 관측할 사망자 수 를 정해놓는 경우 제 3 형태는 임의중도 절단(Random Censoring) 으로 연구자가 제어하지 못하는 이유로 중도절단 되는 경우 이다.
2
다음은 폐암 환자들의 생존 자료이다. 이 자료를 바탕으로 각 구간별 유효인원 수, 사망률, 생존율, 생존 함수를 추정하고 생존 함수 그래프를 그려보아라.
데이터
| 구간 | 사망자수 | 중도절단수 | 위험그룹인원수 |
|---|---|---|---|
| (0, 1] | 82 | 0 | 555 |
| (1, 2] | 30 | 8 | 473 |
| (2, 3] | 27 | 8 | 435 |
| (3, 4] | 22 | 7 | 400 |
| (4, 5] | 26 | 7 | 371 |
| (5, 6] | 25 | 28 | 338 |
| (6, 7] | 20 | 31 | 285 |
| (7, 8] | 11 | 32 | 234 |
| (8, 9] | 14 | 24 | 191 |
| (9, 10] | 13 | 27 | 153 |
| (10, 11] | 5 | 22 | 113 |
| (11, 12] | 5 | 23 | 86 |
| (12, 13] | 5 | 18 | 58 |
| (13, 14] | 2 | 9 | 35 |
| (14, 15] | 3 | 7 | 24 |
| (15, 15] | 3 | 11 | 14 |
제시된 데이터를 바탕으로 생명표와 생존함수 곡선 그래프를 작성했다.
생명표
| 구간 | 사망자수 | 중도절단수 | 위험그룹인원수 | 사망률 | 생존율 | 생존함수 |
|---|---|---|---|---|---|---|
| (0, 1] | 82 | 0 | 555 | 0.1477477 | 0.8522523 | 1.000000 |
| (1, 2] | 30 | 8 | 473 | 0.0639659 | 0.9360341 | 0.852252 |
| (2, 3] | 27 | 8 | 435 | 0.0626450 | 0.9373550 | 0.797737 |
| (3, 4] | 22 | 7 | 400 | 0.0554855 | 0.9445145 | 0.747763 |
| (4, 5] | 26 | 7 | 371 | 0.0707483 | 0.9292517 | 0.706273 |
| (5, 6] | 25 | 28 | 338 | 0.0771605 | 0.9228395 | 0.656305 |
| (6, 7] | 20 | 31 | 285 | 0.0742115 | 0.9257885 | 0.605664 |
| (7, 8] | 11 | 32 | 234 | 0.0504587 | 0.9495413 | 0.560717 |
| (8, 9] | 14 | 24 | 191 | 0.0782123 | 0.9217877 | 0.532424 |
| (9, 10] | 13 | 27 | 153 | 0.0931900 | 0.9068100 | 0.490782 |
| (10, 11] | 5 | 22 | 113 | 0.0490196 | 0.9509804 | 0.445046 |
| (11, 12] | 5 | 23 | 86 | 0.0671141 | 0.9328859 | 0.423230 |
| (12, 13] | 5 | 18 | 58 | 0.1020408 | 0.8979592 | 0.394825 |
| (13, 14] | 2 | 9 | 35 | 0.0655738 | 0.9344262 | 0.354537 |
| (14, 15] | 3 | 7 | 24 | 0.1463415 | 0.8536585 | 0.331289 |
| (15, 15] | 3 | 11 | 14 | 0.3529412 | 0.6470588 | 0.282807 |
첫 구간과 마지막 두 구간에서 높은 사망률을 보이고 나머지 구간에서는 균등한 사망률을 보이고 있다.
생존곡선
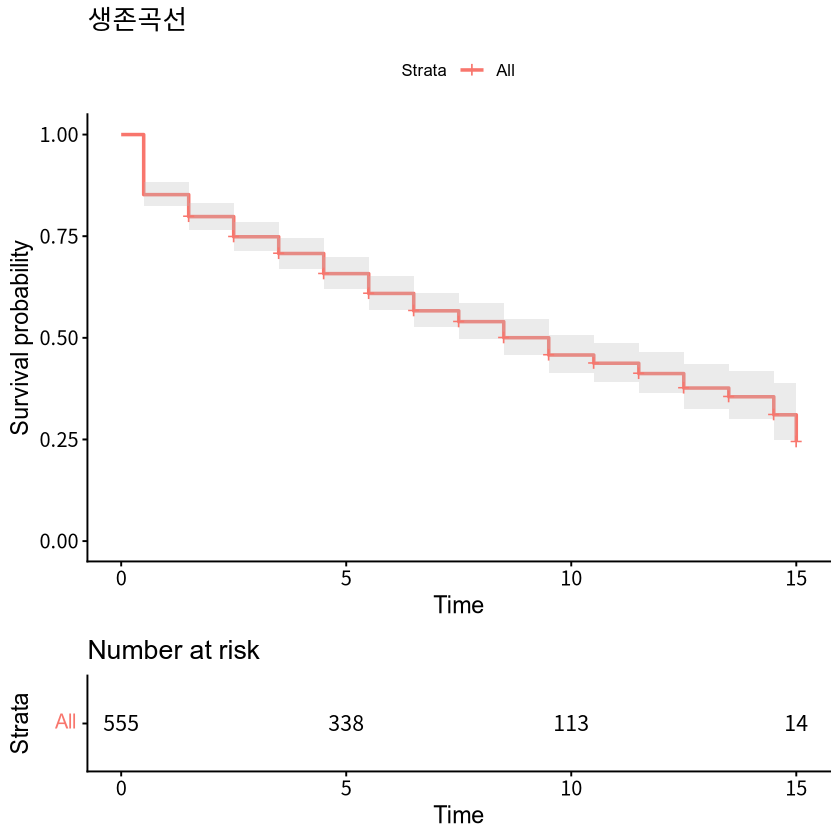
생존함수 곡선에서 첫 구간 및 마지막 두 구간의 하강폭이 다른 구간에 비해 상대적으로 조금 더 가파른것을 볼 수 있다.
부록
data <- data.frame(
    lower = c(
    0, 1, 2, 3, 4, 5 , 6, 7, 8, 9,
    10, 11, 12, 13, 14, 15
    ),
    upper = c(
    1, 2, 3, 4, 5, 6, 7, 8, 9,
    10, 11, 12, 13, 14, 15, 15
    ),
    failed = c(
    82, 30, 27, 22, 26, 25, 20, 11, 14,
    13, 5, 5, 5, 2, 3, 3
    ),
    censored = c(
    0, 8, 8, 7, 7, 28, 31, 32, 24, 27,
    22, 23, 18, 9, 7, 11
    ),
    dgroup = c(
    555, 473, 435, 400, 371, 338, 285, 234, 191,
    153, 113, 86, 58, 35, 24, 14
    )
)


data$Interval <- paste("[", data$lower, ", ", data$upper, ")", sep="")
data <- data[, c("Interval", "lower", "upper", "failed", "censored", "dgroup")]

data <- as.data.frame(data)
life_table <- create_lt(data)

surv_obj <- Surv(surv_data$time, surv_data$event)
km_fit <- survfit(surv_obj ~ 1)

summary(km_fit)

ggsurvplot(km_fit,
    data = data,
    conf.int = TRUE,
    pval = TRUE,
    risk.table = TRUE,
title = "생존곡선"
)
3
다음은 직장암 환자들의 생존시간에 관한 자료이다.
| id | 생존시간 | id | 생존시간 |
|---|---|---|---|
| 1 | 2 | 17 | 27 |
| 2 | 4 | 18 | 30+ |
| 3 | 5 | 19 | 31 |
| 4 | 10 | 20 | 34 |
| 5 | 10+ | 21 | 35 |
| 6 | 12 | 22 | 37+ |
| 7 | 12+ | 23 | 38 |
| 8 | 14 | 24 | 39 |
| 9 | 14 | 25 | 42+ |
| 10 | 15 | 26 | 43+ |
| 11 | 16 | 27 | 46 |
| 12 | 18 | 28 | 47+ |
| 13 | 19 | 29 | 49 |
| 14 | 23 | 30 | 50 |
| 15 | 25 | 31 | 53+ |
| 16 | 26+ | 32 | 54 |
Kaplan-Meier Method
| 구간 | 위험그룹 인원수 |
사망자 수 | 생존율 | 표준 오차 |
95% 신뢰구간 하위 | 95% 신뢰구간 상위 |
|---|---|---|---|---|---|---|
| 2 | 32 | 1 | 0.969 | 0.0308 | 0.910 | 1.000 |
| 4 | 31 | 1 | 0.938 | 0.0428 | 0.857 | 1.000 |
| 5 | 30 | 1 | 0.906 | 0.0515 | 0.811 | 1.000 |
| 10 | 29 | 1 | 0.875 | 0.0585 | 0.768 | 0.997 |
| 12 | 27 | 1 | 0.843 | 0.0647 | 0.725 | 0.979 |
| 14 | 25 | 2 | 0.775 | 0.0750 | 0.641 | 0.937 |
| 15 | 23 | 1 | 0.741 | 0.0790 | 0.602 | 0.914 |
| 16 | 22 | 1 | 0.708 | 0.0823 | 0.564 | 0.889 |
| 18 | 21 | 1 | 0.674 | 0.0850 | 0.527 | 0.863 |
| 19 | 20 | 1 | 0.640 | 0.0871 | 0.490 | 0.836 |
| 23 | 19 | 1 | 0.607 | 0.0888 | 0.455 | 0.808 |
| 25 | 18 | 1 | 0.573 | 0.0901 | 0.421 | 0.780 |
| 27 | 16 | 1 | 0.537 | 0.0913 | 0.385 | 0.749 |
| 31 | 14 | 1 | 0.499 | 0.0925 | 0.347 | 0.717 |
| 34 | 13 | 1 | 0.460 | 0.0930 | 0.310 | 0.684 |
| 35 | 12 | 1 | 0.422 | 0.0928 | 0.274 | 0.649 |
| 38 | 10 | 1 | 0.380 | 0.0926 | 0.236 | 0.613 |
| 39 | 9 | 1 | 0.338 | 0.0914 | 0.199 | 0.574 |
| 46 | 6 | 1 | 0.281 | 0.0919 | 0.148 | 0.534 |
| 49 | 4 | 1 | 0.211 | 0.0920 | 0.090 | 0.496 |
| 50 | 3 | 1 | 0.141 | 0.0840 | 0.044 | 0.454 |
| 54 | 1 | 1 | 0.000 |
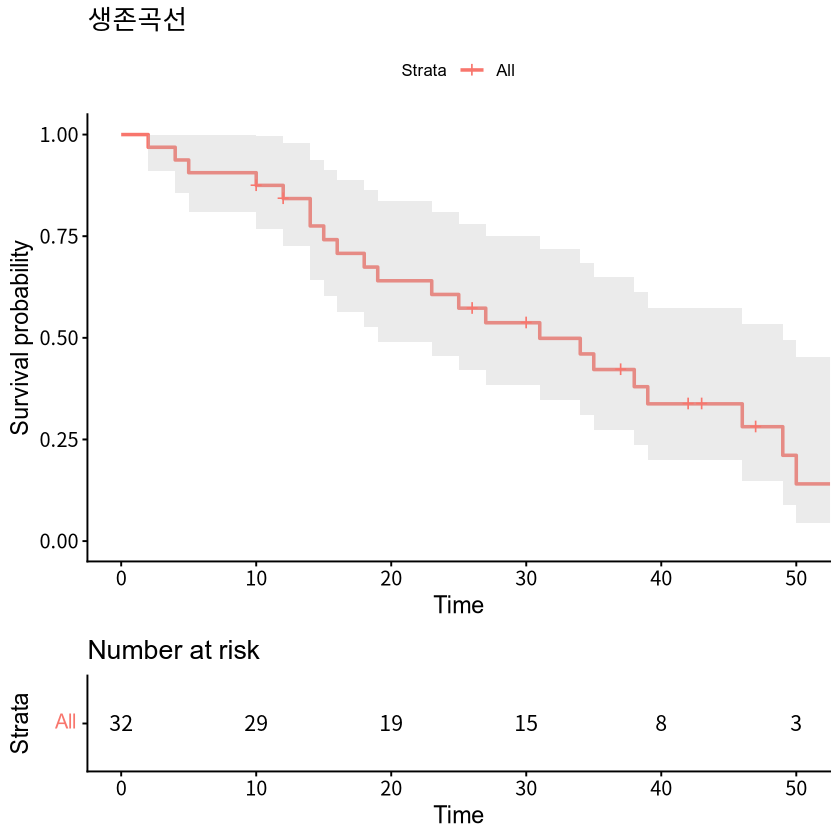
생존곡선
부록
data <- data.frame(
    Id = 1:32,
    time = c(
        2, 4, 5, 10, 10, 12, 12, 14, 14, 15,
        16, 18, 19, 23, 25, 26, 27, 30, 31, 34,
        35, 37, 38, 39, 42, 43, 46, 47, 49, 50,
        53, 54
    ),
    event = c(
        1, 1, 1, 1, 0, 1, 0, 1, 1, 1,
        1, 1, 1, 1, 1, 0, 1, 0, 1, 1,
        1, 0, 1, 1, 0, 0, 1, 0, 1, 1,
        0, 1
    )
    # event: 1 = 사건 발생, 0 = 중도절단
)

model <- survfit(Surv(time, event) ~ 1, data = data)
summary(model)

ggsurvplot(model,
    data = data,
    conf.int = TRUE,
    pval = TRUE,
    risk.table = TRUE,
    title = "생존곡선")
    cat("\n중앙 생존 시간 (Median Survival Time):",
    model$time[which.min(abs(model$surv - 0.5))], "일\n"
)
7
다음은 7.5.3 절에 예로 든 심장이식 수술에 대한 데이터의 일부이다. 이식 전까지 기다린 시간이 생존시간보다 크거나 또는 이식을 받지 못하는 경우의 '이식상태=0' 그 외의 경우는 '이식상태=1' 인 시간의존-공변량으로 간주하고 나머지 변수들인 나이,심장수술 경험 유무 (0=무,1=유)를 공변량으로 하여 비례위험모형을 적합시키고 각 설명변수들의 유의성 검정을 유의수준 5% 하에서 검정하여라.
원데이터
| 환자번호 | 중도절단여부 | 생존시간 | 나이 (단위 : 일) |
이식전까지 기다린시간 |
심장 수술 경험 여부 |
|---|---|---|---|---|---|
| 1 | 1 | 28 | 20191 | 18 | 0 |
| 2 | 1 | 1032 | 15831 | 8 | 0 |
| 3 | 1 | 51 | 15627 | 12 | 0 |
| 4 | 1 | 733 | 21315 | 3 | 0 |
| 5 | 1 | 219 | 18920 | 83 | 0 |
| 6 | 0 | 1800 | 12315 | 25 | 0 |
| 7 | 0 | 1401 | 11153 | 0 | 0 |
| 8 | 1 | 263 | 3209 | 0 | 0 |
| 9 | 1 | 100 | 17870 | 46 | 0 |
| 10 | 1 | 66 | 22463 | 19 | 0 |
| 11 | 1 | 0 | 15147 | 5 | 5 |
| 12 | 1 | 0 | 18452 | 53 | 2 |
| 13 | 0 | 1408 | 17708 | 41 | 1 |
| 14 | 0 | 1322 | 16547 | 58 | 1 |
| 15 | 1 | 3 | 13310 | 0 | 0 |
| 16 | 1 | 2 | 15849 | 0 | 1 |
| 17 | 1 | 40 | 15552 | 0 | 1 |
| 18 | 1 | 45 | 13216 | 1 | 0 |
| 19 | 1 | 996 | 17755 | 2 | 1 |
| 20 | 1 | 72 | 17203 | 21 | 0 |
| 21 | 1 | 9 | 20467 | 0 | 0 |
| 22 | 0 | 1142 | 13388 | 36 | 1 |
| 23 | 1 | 980 | 16760 | 831 | NA |
| 24 | 1 | 285 | 17800 | 32 | 0 |
| 25 | 1 | 102 | 15066 | 0 | 0 |
| 26 | 1 | 188 | 17292 | 41 | 0 |
| 27 | 1 | 3 | 174560 | 0 | NA |
| 28 | 1 | 61 | 19159 | 10 | 0 |
| 29 | 0 | 942 | 14151 | 67 | 0 |
| 30 | 1 | 149 | 15072 | 0 | 0 |
| 31 | 1 | 343 | 17538 | 21 | 1 |
| 32 | 0 | 916 | 15115 | 78 | 1 |
| 33 | 1 | 68 | 17917 | 3 | 0 |
| 34 | 1 | 2 | 19199 | 0 | 0 |
| 35 | 1 | 69 | 14374 | 0 | 0 |
| 36 | 0 | 842 | 11929 | 27 | 0 |
| 37 | 1 | 584 | 17830 | 33 | 1 |
| 38 | 1 | 78 | 18735 | 12 | 0 |
| 39 | 1 | 32 | 19436 | 0 | 0 |
| 40 | 1 | 285 | 7141 | 57 | 0 |
| 41 | 0 | 370 | 19856 | 31 | 0 |
| 42 | 1 | 207 | 18645 | 139 | 0 |
| 43 | 1 | 340 | 17384 | 0 | 0 |
| 44 | 0 | 340 | 16430 | 310 | 0 |
| 45 | 0 | 265 | 17441 | 28 | 0 |
| 46 | 1 | 165 | 16013 | 4 | 1 |
| 47 | 1 | 16 | 14713 | 2 | 0 |
| 48 | 0 | 180 | 9734 | 13 | 0 |
| 49 | 0 | 131 | 8626 | 21 | 0 |
가공 데이터
생존시간 이 0 인 환자와 심장 수술 경험 여부에서 결측치가 존재하여 4개 환자 데이터를 제외하고 분석하였다. 또한 나이의 단위가 "일" 로 되어있어, "년" 단위로 변환하였다.
| 환자번호 | 중도절단여부 | 생존시간 | 나이 (단위 : 년) |
이식여부 | 심장 수술 경험 여부 |
|---|---|---|---|---|---|
| 1 | 1 | 28 | 55 | 1 | 0 |
| 2 | 1 | 1032 | 43 | 1 | 0 |
| 3 | 1 | 51 | 43 | 1 | 0 |
| 4 | 1 | 733 | 58 | 1 | 0 |
| 5 | 1 | 219 | 52 | 1 | 0 |
| 6 | 0 | 1800 | 34 | 1 | 0 |
| 7 | 0 | 1401 | 31 | 0 | 0 |
| 8 | 1 | 263 | 9 | 0 | 0 |
| 9 | 1 | 100 | 49 | 1 | 0 |
| 10 | 1 | 66 | 62 | 1 | 0 |
| 11 | 0 | 1408 | 49 | 1 | 1 |
| 12 | 0 | 1322 | 45 | 1 | 1 |
| 13 | 1 | 3 | 36 | 0 | 0 |
| 14 | 1 | 2 | 43 | 0 | 1 |
| 15 | 1 | 40 | 43 | 0 | 1 |
| 16 | 1 | 45 | 36 | 1 | 0 |
| 17 | 1 | 996 | 49 | 1 | 1 |
| 18 | 1 | 72 | 47 | 1 | 0 |
| 19 | 1 | 9 | 56 | 0 | 0 |
| 20 | 0 | 1142 | 37 | 1 | 1 |
| 21 | 1 | 285 | 49 | 1 | 0 |
| 22 | 1 | 102 | 41 | 0 | 0 |
| 23 | 1 | 188 | 47 | 1 | 0 |
| 24 | 1 | 61 | 52 | 1 | 0 |
| 25 | 0 | 942 | 39 | 1 | 0 |
| 26 | 1 | 149 | 41 | 0 | 0 |
| 27 | 1 | 343 | 48 | 1 | 1 |
| 28 | 0 | 916 | 41 | 1 | 1 |
| 29 | 1 | 68 | 49 | 1 | 0 |
| 30 | 1 | 2 | 53 | 0 | 0 |
| 31 | 1 | 69 | 39 | 0 | 0 |
| 32 | 0 | 842 | 33 | 1 | 0 |
| 33 | 1 | 584 | 49 | 1 | 1 |
| 34 | 1 | 78 | 51 | 1 | 0 |
| 35 | 1 | 32 | 53 | 0 | 0 |
| 36 | 1 | 285 | 20 | 1 | 0 |
| 37 | 0 | 370 | 54 | 1 | 0 |
| 38 | 1 | 207 | 51 | 1 | 0 |
| 39 | 1 | 340 | 48 | 0 | 0 |
| 40 | 0 | 340 | 45 | 1 | 0 |
| 41 | 0 | 265 | 48 | 1 | 0 |
| 42 | 1 | 165 | 44 | 1 | 1 |
| 43 | 1 | 16 | 40 | 1 | 0 |
| 44 | 0 | 180 | 27 | 1 | 0 |
| 45 | 0 | 131 | 24 | 1 | 0 |
Kaplan-Meier Method
| 구간 | 위험그룹 인원수 |
사망자 수 | 생존률 | 표준오차 | 95% 신뢰구간 하위 | 95% 신뢰구간 상위 |
|---|---|---|---|---|---|---|
| 2 | 45 | 2 | 0.956 | 0.031 | 0.897 | 1.000 |
| 3 | 43 | 1 | 0.933 | 0.037 | 0.863 | 1.000 |
| 9 | 42 | 1 | 0.911 | 0.042 | 0.832 | 0.998 |
| 16 | 41 | 1 | 0.889 | 0.047 | 0.802 | 0.986 |
| 28 | 40 | 1 | 0.867 | 0.051 | 0.773 | 0.972 |
| 32 | 39 | 1 | 0.844 | 0.054 | 0.745 | 0.957 |
| 40 | 38 | 1 | 0.822 | 0.057 | 0.718 | 0.942 |
| 45 | 37 | 1 | 0.800 | 0.060 | 0.691 | 0.926 |
| 51 | 36 | 1 | 0.778 | 0.062 | 0.665 | 0.909 |
| 61 | 35 | 1 | 0.756 | 0.064 | 0.640 | 0.892 |
| 66 | 34 | 1 | 0.733 | 0.066 | 0.615 | 0.875 |
| 68 | 33 | 1 | 0.711 | 0.068 | 0.590 | 0.857 |
| 69 | 32 | 1 | 0.689 | 0.069 | 0.566 | 0.838 |
| 72 | 31 | 1 | 0.667 | 0.070 | 0.542 | 0.820 |
| 78 | 30 | 1 | 0.644 | 0.071 | 0.519 | 0.801 |
| 100 | 29 | 1 | 0.622 | 0.072 | 0.496 | 0.781 |
| 102 | 28 | 1 | 0.600 | 0.073 | 0.473 | 0.762 |
| 149 | 26 | 1 | 0.577 | 0.074 | 0.449 | 0.741 |
| 165 | 25 | 1 | 0.554 | 0.074 | 0.426 | 0.721 |
| 188 | 23 | 1 | 0.530 | 0.075 | 0.402 | 0.699 |
| 207 | 22 | 1 | 0.506 | 0.075 | 0.378 | 0.677 |
| 219 | 21 | 1 | 0.482 | 0.075 | 0.354 | 0.655 |
| 263 | 20 | 1 | 0.458 | 0.075 | 0.331 | 0.632 |
| 285 | 18 | 2 | 0.407 | 0.075 | 0.283 | 0.584 |
| 340 | 16 | 1 | 0.381 | 0.075 | 0.260 | 0.559 |
| 343 | 14 | 1 | 0.354 | 0.074 | 0.235 | 0.534 |
| 584 | 12 | 1 | 0.325 | 0.074 | 0.208 | 0.506 |
| 733 | 11 | 1 | 0.295 | 0.073 | 0.182 | 0.478 |
| 996 | 7 | 1 | 0.253 | 0.073 | 0.143 | 0.447 |
| 1032 | 6 | 1 | 0.211 | 0.072 | 0.108 | 0.413 |
모형식
- \(h_i(t)\) : i번째 대상자의 시간 t 에서의 누적위험함수
- \(h_o(t)\) : 기저위험함수 [공변량의 값이 모두 0 일때, 위험함수의 값]
- \(i\) : 환자 번호 [\(1:45\)]
- \(\beta_1\) : 나이의 회귀계수
- \(\beta_2\) : 이식 상태의 회귀 계수
- \(\beta_3\) : 심장수술 경험 유무의 회귀 계수
- \(X_1\) : 나이 공변량 [단위 : 년]
- \(X_2\) : 이식 상태 시간의존 공변량
-
\[0: 생존시간이 더 짧거나 이식을 받은 경우 , 1: 생존시간이 더 긴 경우\]
-
- \(X_3\) : 심장수술 경험 유무 공변량
-
\[0: 없음 , 1: 있음\]
-
결과 및 해석
공변량
\(H_0\) : 공변량 효과는 모두 없다. \(H_1\) : 공변량 중 적어도 하나는 효과가 있다.
n= 45, number of events= 34
Concordance= 0.713 (se = 0.047 )
| \(\chi^2\) | Df | p | |
|---|---|---|---|
| Likelihood ratio | 15.33 | 3 | 0.002 |
| Wald test | 15.45 | 3 | 0.001 |
| Score (logrank) | 16.81 | 3 | < 0.0001 |
공변량의 효과에 대해 검정하였다. 결과적으로 Likelihood ratio, Wald, Score 검정통계량 모두 p<0.05 이므로 공변량의 효과가 유의함을 확인하였다. -> 모형적합도 검정
모형
| coef | exp(coef) | se(coef) | z | p | lower. 95 | upper .95 | |
|---|---|---|---|---|---|---|---|
| age | 0.05772 | 1.0594 | 0.0224 | 2.578 | 0.00995 | 1.0139 | 1.1069 |
| trans plant1 |
-1.3078 | 0.2704 | 0.4240 | -3.084 | 0.00204 | 0.1178 | 0.6209 |
| heart1 | -0.5060 | 0.6029 | 0.4849 | -1.043 | 0.29672 | 0.2331 | 1.5595 |
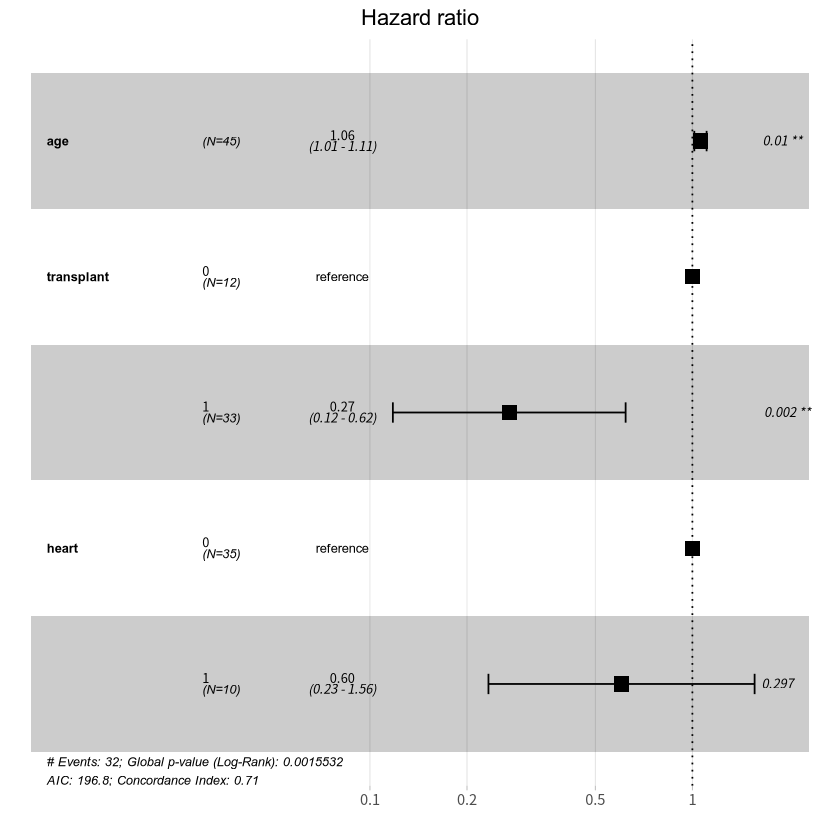
\(HR_{\;age}\) = \(\exp(0.05772)\approx 1.0594\) \(HR_{\;transplant}\) = \(\exp(-1.3078)\approx 0.2704\) \(HR_{\;heart}\) = \(\exp(-0.5060)\approx 0.6029\)
나이가 한단위 (1 년) 증가할 때마다 사망 위험도가 약 5.94% 증가한다. 검정통계량 \(z=2.578\) , \(p=0.00995\) 에서 통계적으로 유의하게 나타났다.
이식 수술 전까지 기다린 시간이 생존 시간보다 짧은 경우 사망 위험도가 약 72.96% 감소한다. 즉, 빠르게 이식을 받은 환자들이 더 오래 생존하는 경향을 보인다. 이는 검정통계량 \(z=-3.084\) , \(p=0.00204\) 에서 통계적으로 유의하게 나타났다.
심장수술 경험이 있는 환자의 사망 위험도는 약 39.71% 낮은 경향을 보이지만 신뢰구간이 1 을 포함하며 검정통계량 \(z=-1.043\) , \(p=0.29672\) 로 유의수준 0.05 에서 유의하지 않다.
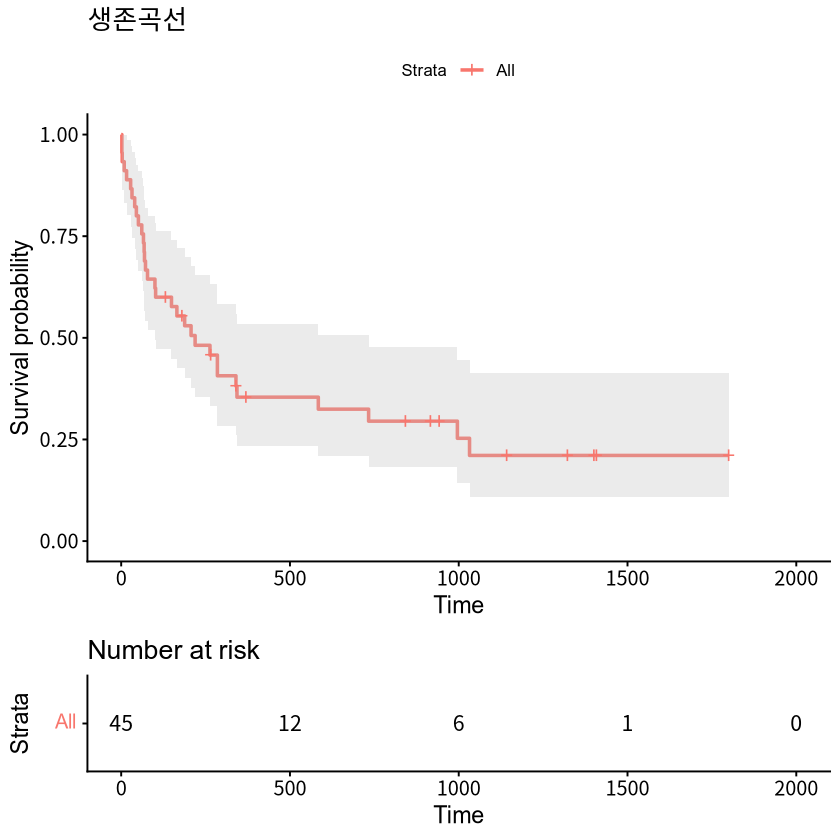
시각화
부록
data <- data.frame(
id = 1:49,
event = c(
1, 1, 1, 1, 1, 0, 0, 1, 1, 1,
1, 1, 0, 0, 1, 1, 1, 1, 1, 1,
1, 0, 1, 1, 1, 1, 1, 1, 0, 1,
1, 0, 1, 1, 1, 0, 1, 1, 1, 1,
0, 1, 1, 0, 0, 1, 1, 0, 0
),
survive = c(
28, 1032, 51, 733, 219, 1800, 1401, 263, 100, 66,
0, 0, 1408, 1322, 3, 2, 40, 45, 996, 72,
9, 1142, 980, 285, 102, 188, 3, 61, 942, 149,
343, 916, 68, 2, 69, 842, 584, 78, 32, 285,
370, 207, 340, 340, 265, 165, 16, 180, 131
),
age = c(
20191, 15831, 15627, 21315, 18920, 12315, 11153, 3209, 17870, 22463,
15147, 18452, 17708, 16547, 13310, 15849, 15552, 13216, 17755, 17203,
20467, 13388, 16760, 17800, 15066, 17292, 174560, 19159, 14151, 15072,
17538, 15115, 17917, 19199, 14374, 11929, 17830, 18735, 19436, 7141,
19856, 18645, 17384, 16430, 17441, 16013, 14713, 9734, 8626
),
wait = c(
18, 8, 12, 3, 83, 25, 0, 0, 46, 19,
5, 53, 41, 58, 0, 0, 0, 1, 2, 21,
0, 36, 831, 32, 0, 41, 0, 10, 67, 0,
21, 78, 3, 0, 0, 27, 33, 12, 0, 57,
31, 139, 0, 310, 28, 4, 2, 13, 21
),
transplant = c(
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
1, 1, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0
),
heart = c(
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
5, 2, 1, 1, 0, 1, 1, 0, 1, 0,
0, 1, 0, 0, 0, 0, 0, 0, 0, 0,
1, 1, 0, 0, 0, 0, 1, 0, 0, 0,
0, 0, 0, 0, 0, 1, 0, 0, 0
)
)

data <- data.frame(
id = 1:45,
event = c(
1, 1, 1, 1, 1, 0, 0, 1, 1, 1,
0, 0, 1, 1, 1, 1, 1, 1,
1, 0, 1, 1, 1, 1, 0, 1,
1, 0, 1, 1, 1, 0, 1, 1, 1, 1,
0, 1, 1, 0, 0, 1, 1, 0, 0
),
survive = c(
28, 1032, 51, 733, 219, 1800, 1401, 263, 100, 66,
1408, 1322, 3, 2, 40, 45, 996, 72,
9, 1142, 285, 102, 188, 61, 942, 149,
343, 916, 68, 2, 69, 842, 584, 78, 32, 285,
370, 207, 340, 340, 265, 165, 16, 180, 131
),
age = c(
20191, 15831, 15627, 21315, 18920, 12315, 11153, 3209, 17870, 22463,
17708, 16547, 13310, 15849, 15552, 13216, 17755, 17203,
20467, 13388, 17800, 15066, 17292, 19159, 14151, 15072,
17538, 15115, 17917, 19199, 14374, 11929, 17830, 18735, 19436, 7141,
19856, 18645, 17384, 16430, 17441, 16013, 14713, 9734, 8626
),
wait = c(
18, 8, 12, 3, 83, 25, 0, 0, 46, 19,
41, 58, 0, 0, 0, 1, 2, 21,
0, 36, 32, 0, 41, 10, 67, 0,
21, 78, 3, 0, 0, 27, 33, 12, 0, 57,
31, 139, 0, 310, 28, 4, 2, 13, 21
),
transplant = c(
1, 1, 1, 1, 1, 1, 0, 0, 1, 1,
1, 1, 0, 0, 0, 1, 1, 1,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0
),
heart = c(
0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
1, 1, 0, 1, 1, 0, 1, 0,
0, 1, 0, 0, 0, 0, 0, 0,
1, 1, 0, 0, 0, 0, 1, 0, 0, 0,
0, 0, 0, 0, 0, 1, 0, 0, 0
)
)


data$age <- round(data$age / 365 )
data$transplant <- ifelse(data$survive >= data$wait & data$wait != 0, 1, 0)
data$transplant <- factor(data$transplant, levels = c(0, 1))
data$heart <- factor(data$heart , levels = c(0, 1))


km_fit <- survfit(Surv(survive, event) ~ 1, data = data)
summary(km_fit)
model <- coxph(Surv(survive, event) ~ age + transplant + heart , data = data)
summary(model)
exp(coef(model)) # HR 추정값
exp(confint(model)) # 95% 신뢰구간
ggforest(model, data= data)

ggsurvplot(km_fit,
    data = data,
    conf.int = TRUE,
    pval = TRUE,
    risk.table = TRUE,
    title = "생존곡선"
)